2026/08/31
RECHARGE/中村屋 サイクロンアース
走行距離が 40,000Km を超えたので、
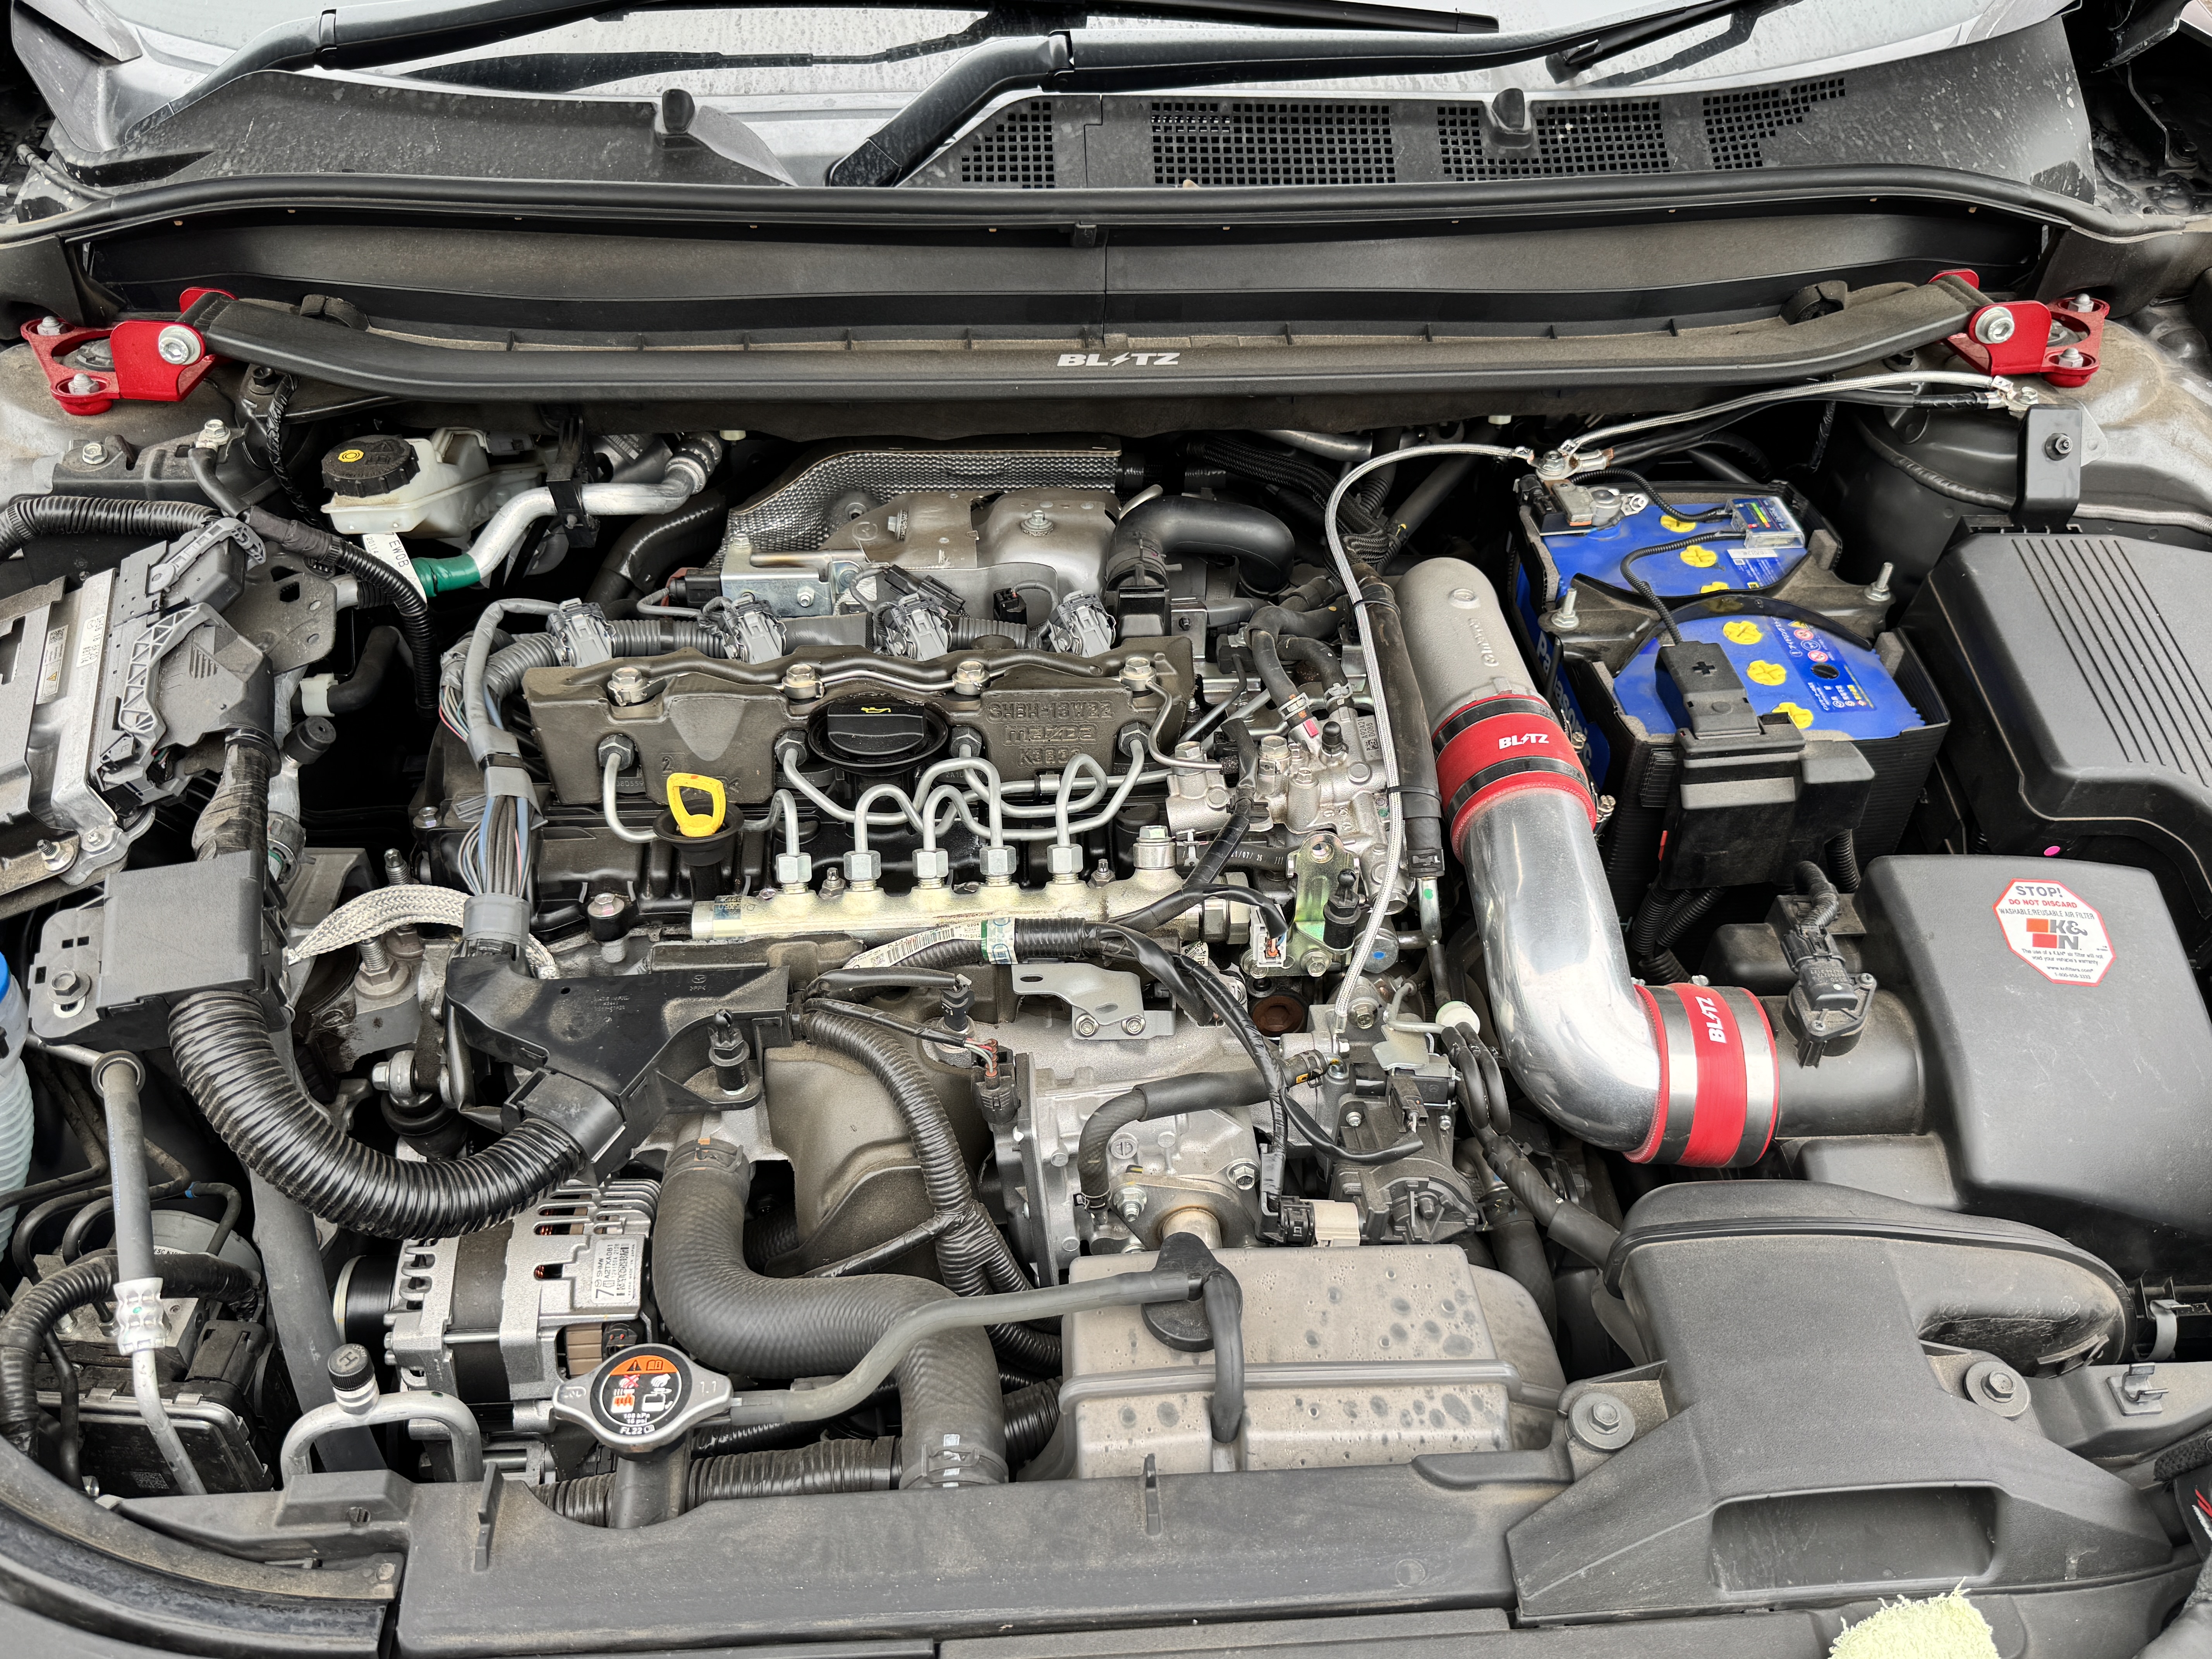
煤対策の一環として RECHARGE/中村屋のサイクロンアース を取り付けました。
こちらの製品は
- バッテリー/ボディー間
- バッテリー/エンジン(EGRバルブ)
- コモンレール付近
車種専用品なので CX-5 に最適な長さとなっていて当然無加工で取り付けが出来ます。
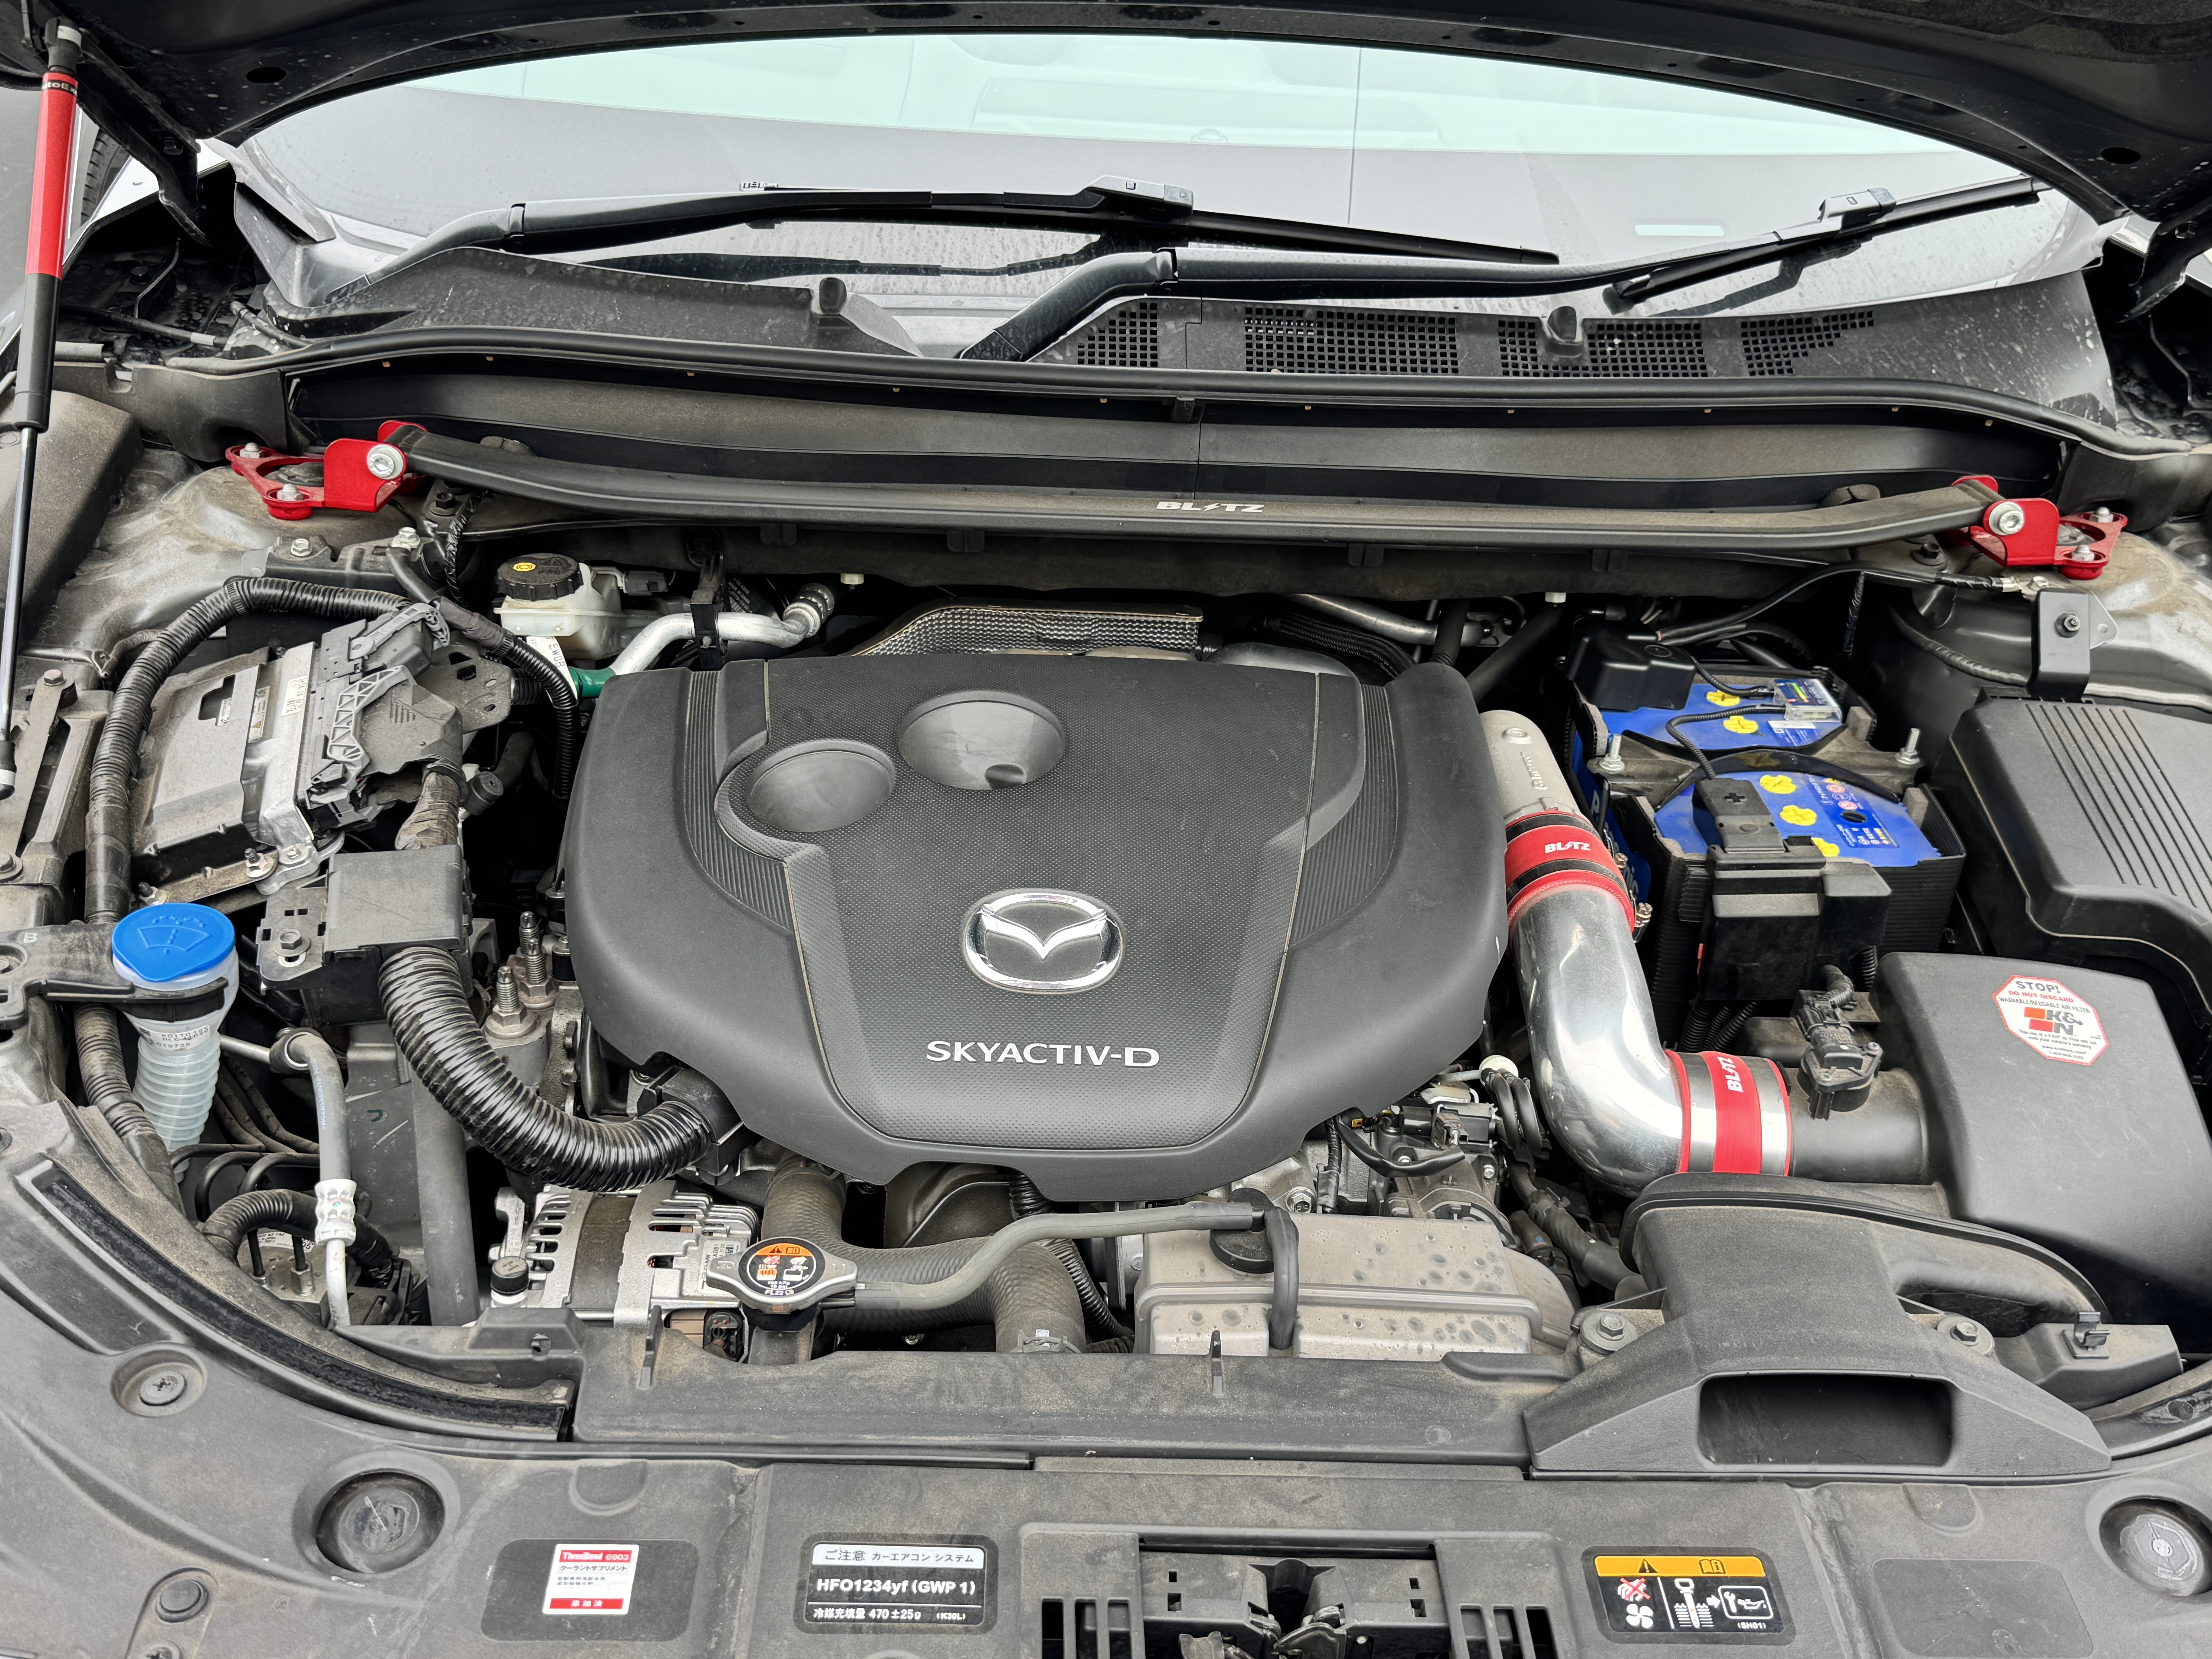
バッテリー/ボディー間はオリジナルのアースと並行して装着します。
バッテリー側は電流センサーの下流につける必要があるとの事なのでこの位置に取り付けます。
バッテリー側とボディー側で穴のサイズが異なるので作業時には注意が必要です
(バッテリー側の穴の方が一回り大きいです)。
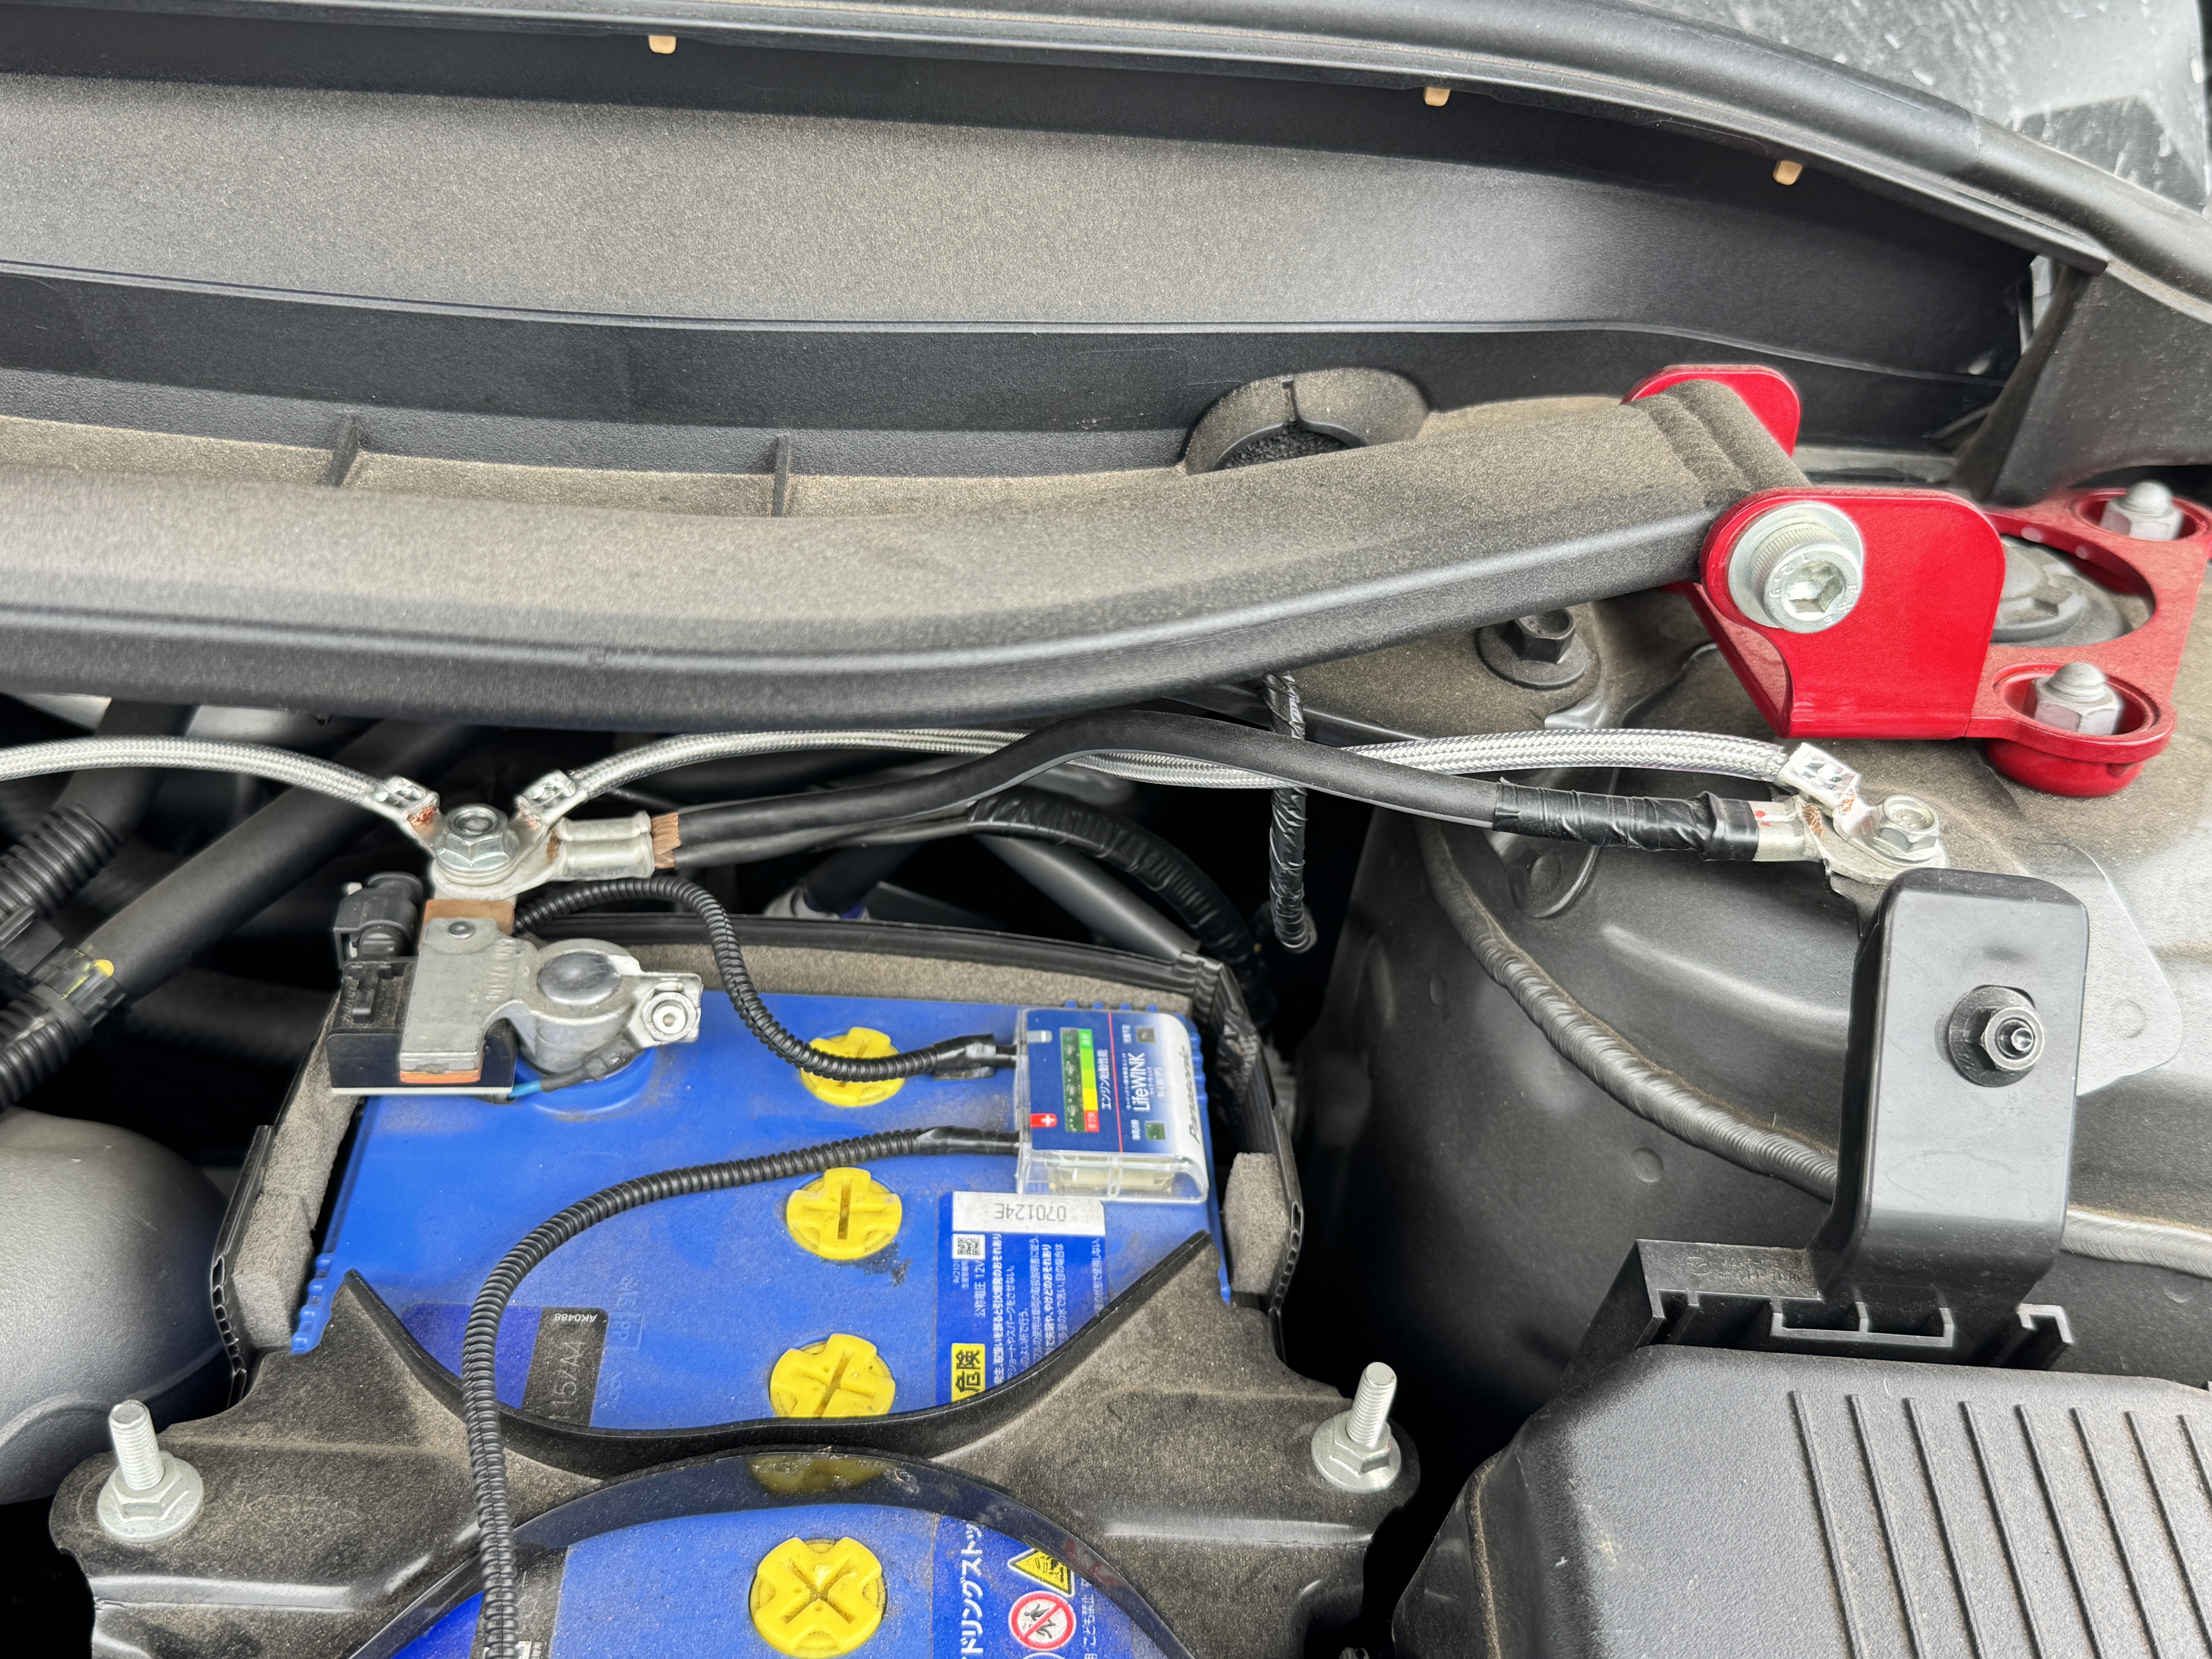
バッテリー/エンジン(EGRバルブ)は CX-5 後期型では取付位置が異なる様なので要注意です。
エンジン側の 10mm ボルトは結構固く締まっていましたが、
奥まっていてラチェットレンチが入らないので若干苦労しました。
ストレートタイプのメガネレンチがあると作業しやすいです。
バッテリー側はボディー間同様電流センサーの下流に取り付けます。
ブラブラするのが嫌なので増し締めした後で並走するパイプとタイラップで軽く固定しました。
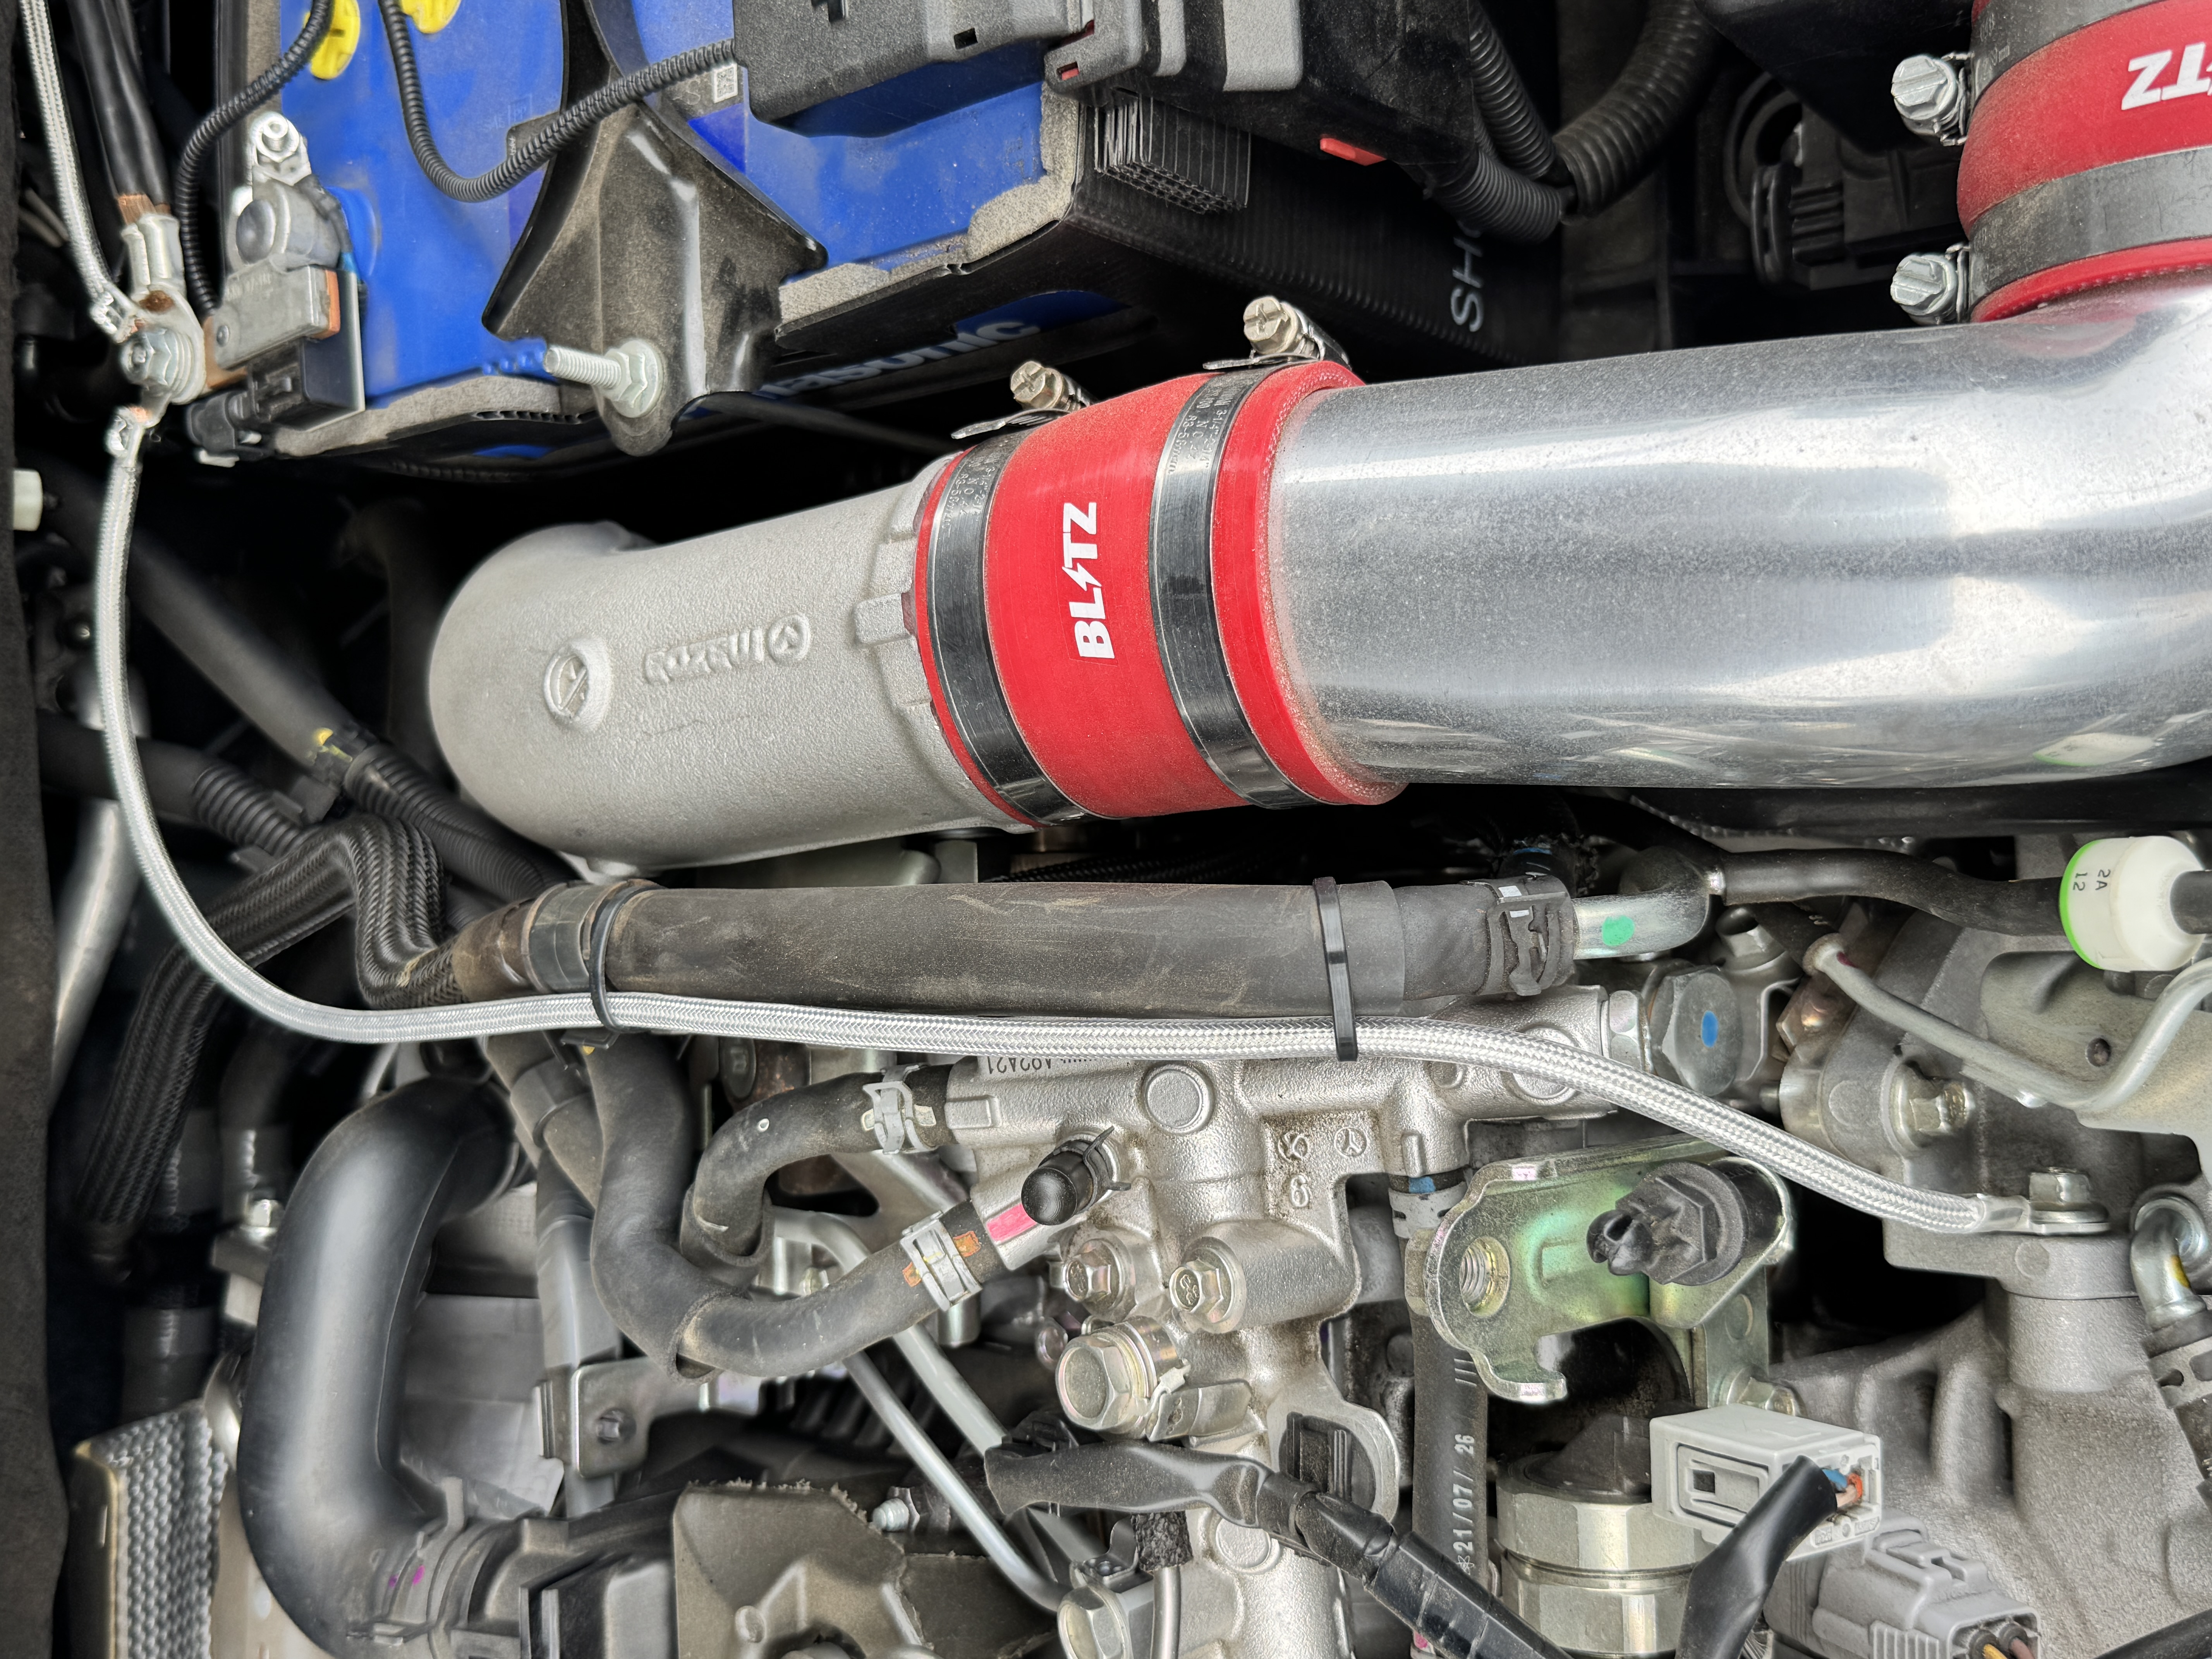
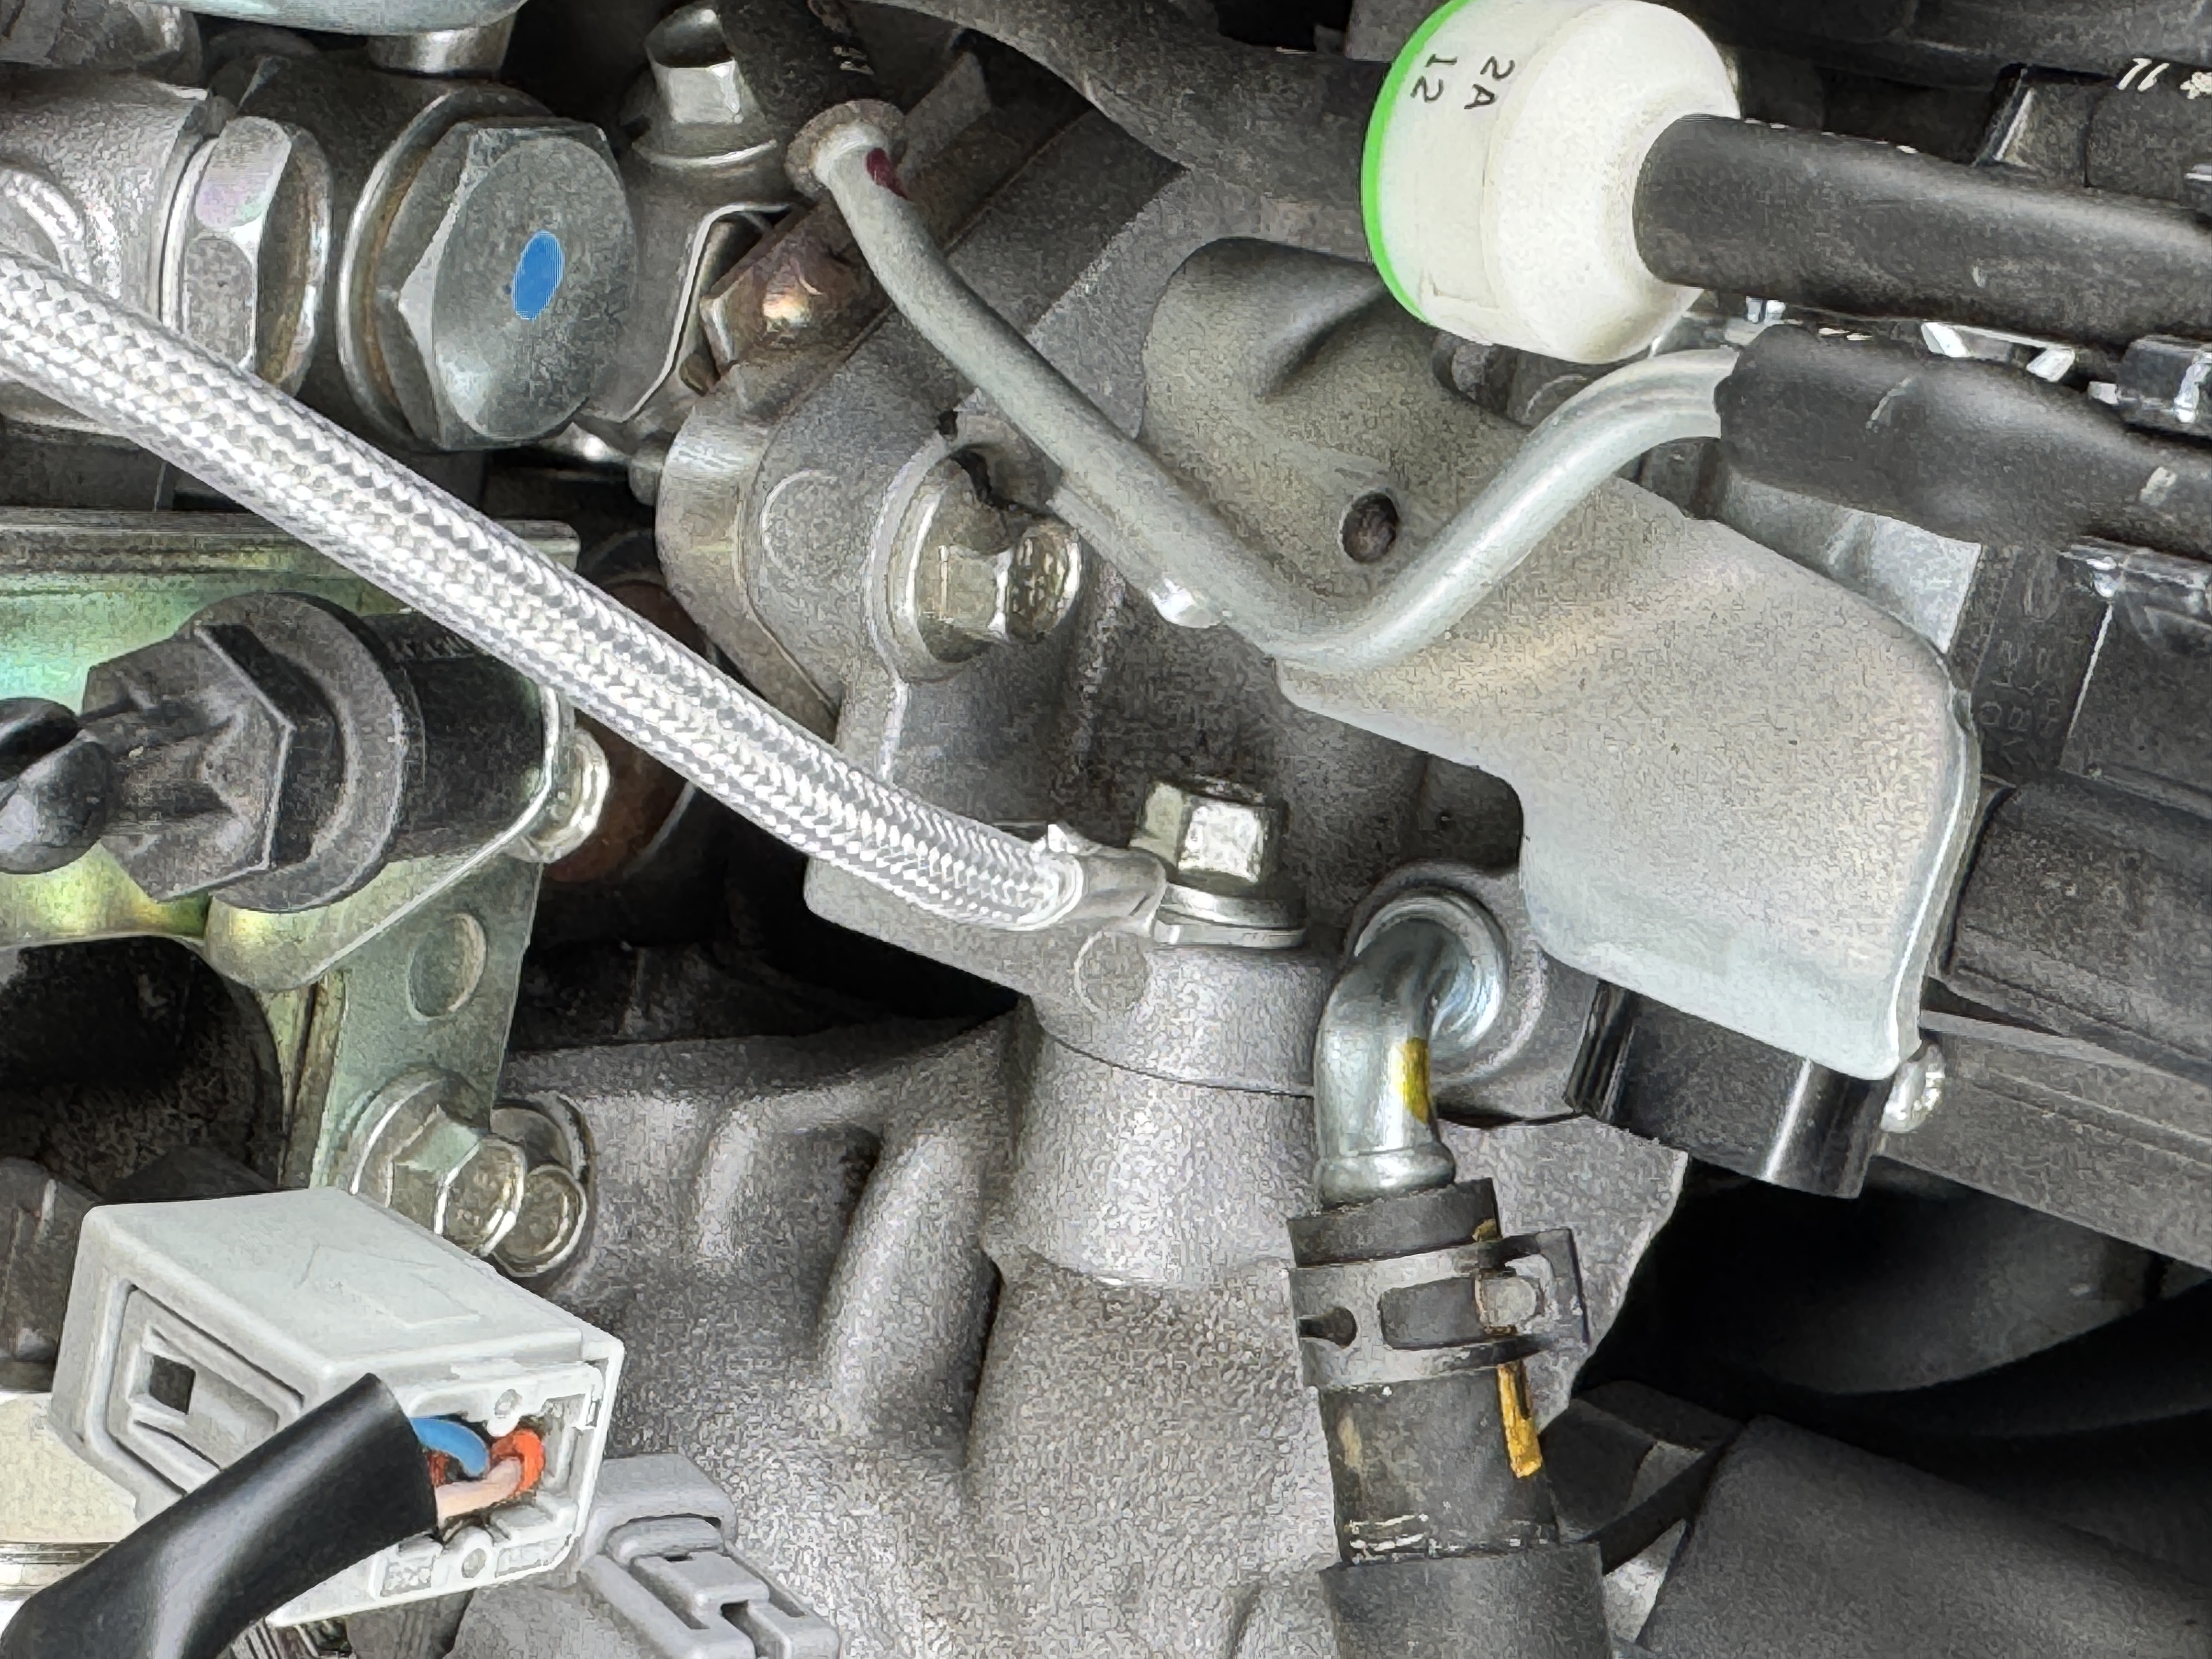
コモンレール付近はエンジンとボディーを接続します。
特に難しい事はありませんがボルトを落とさない様注意します。
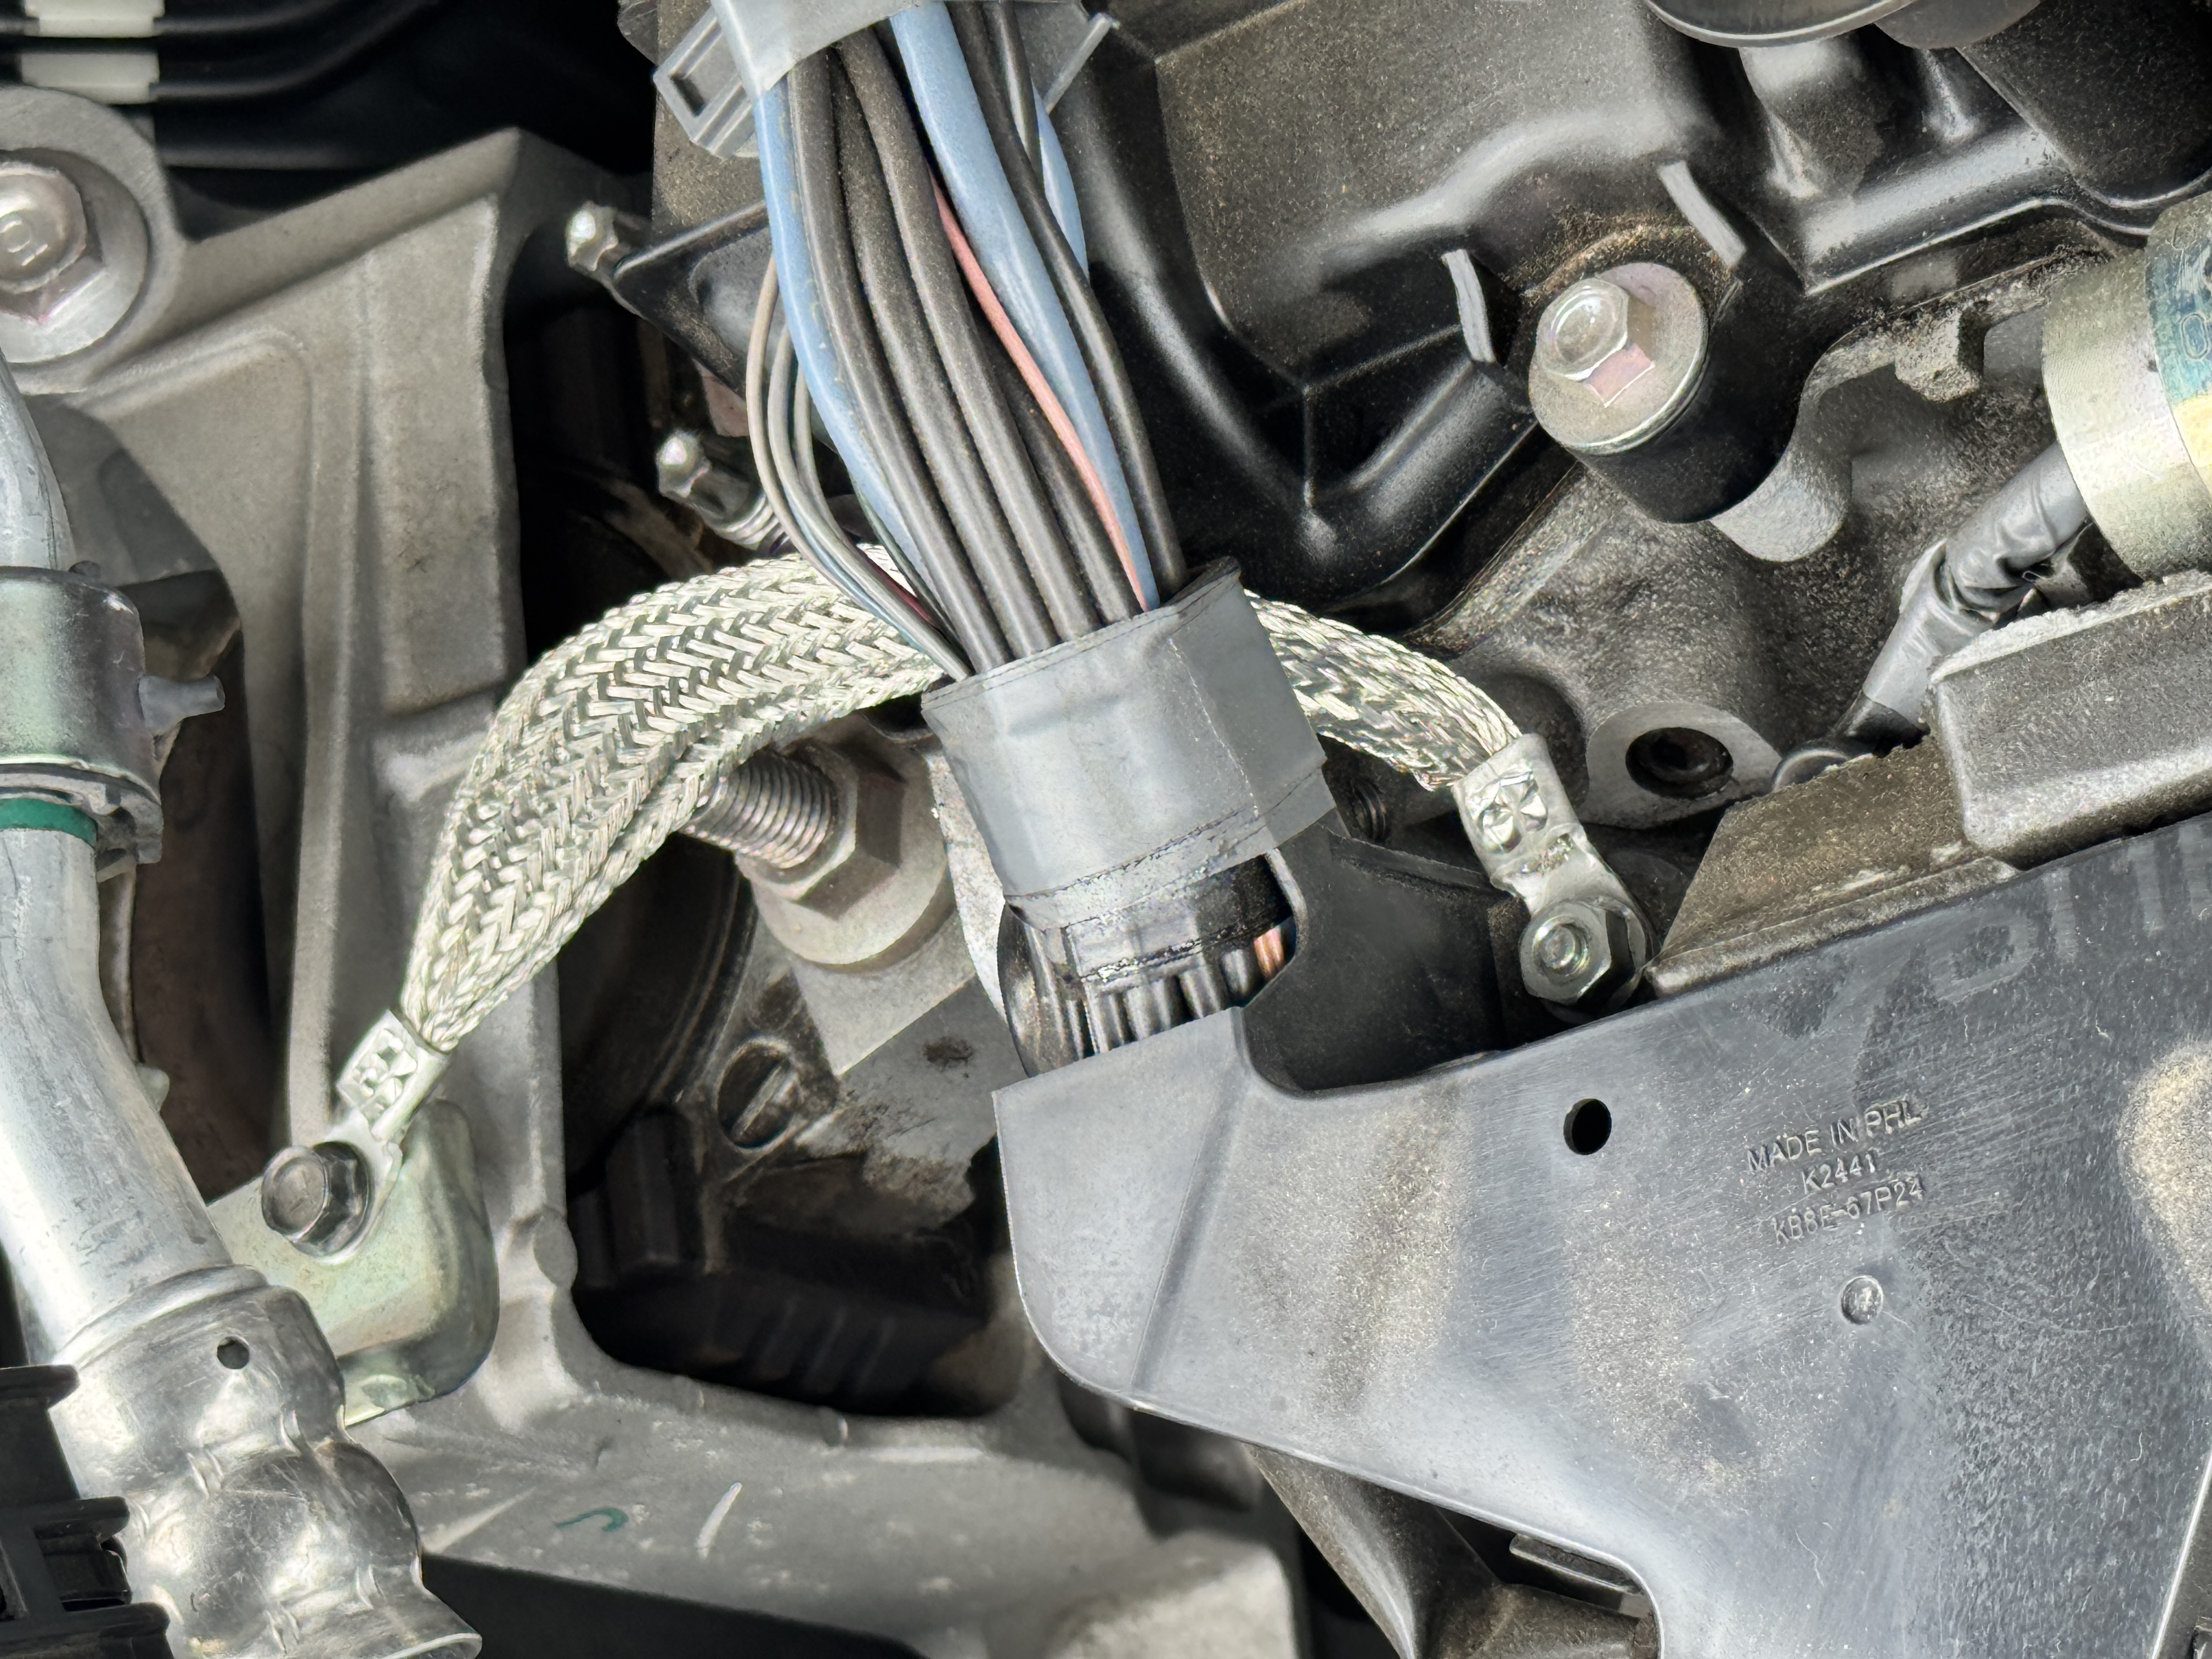
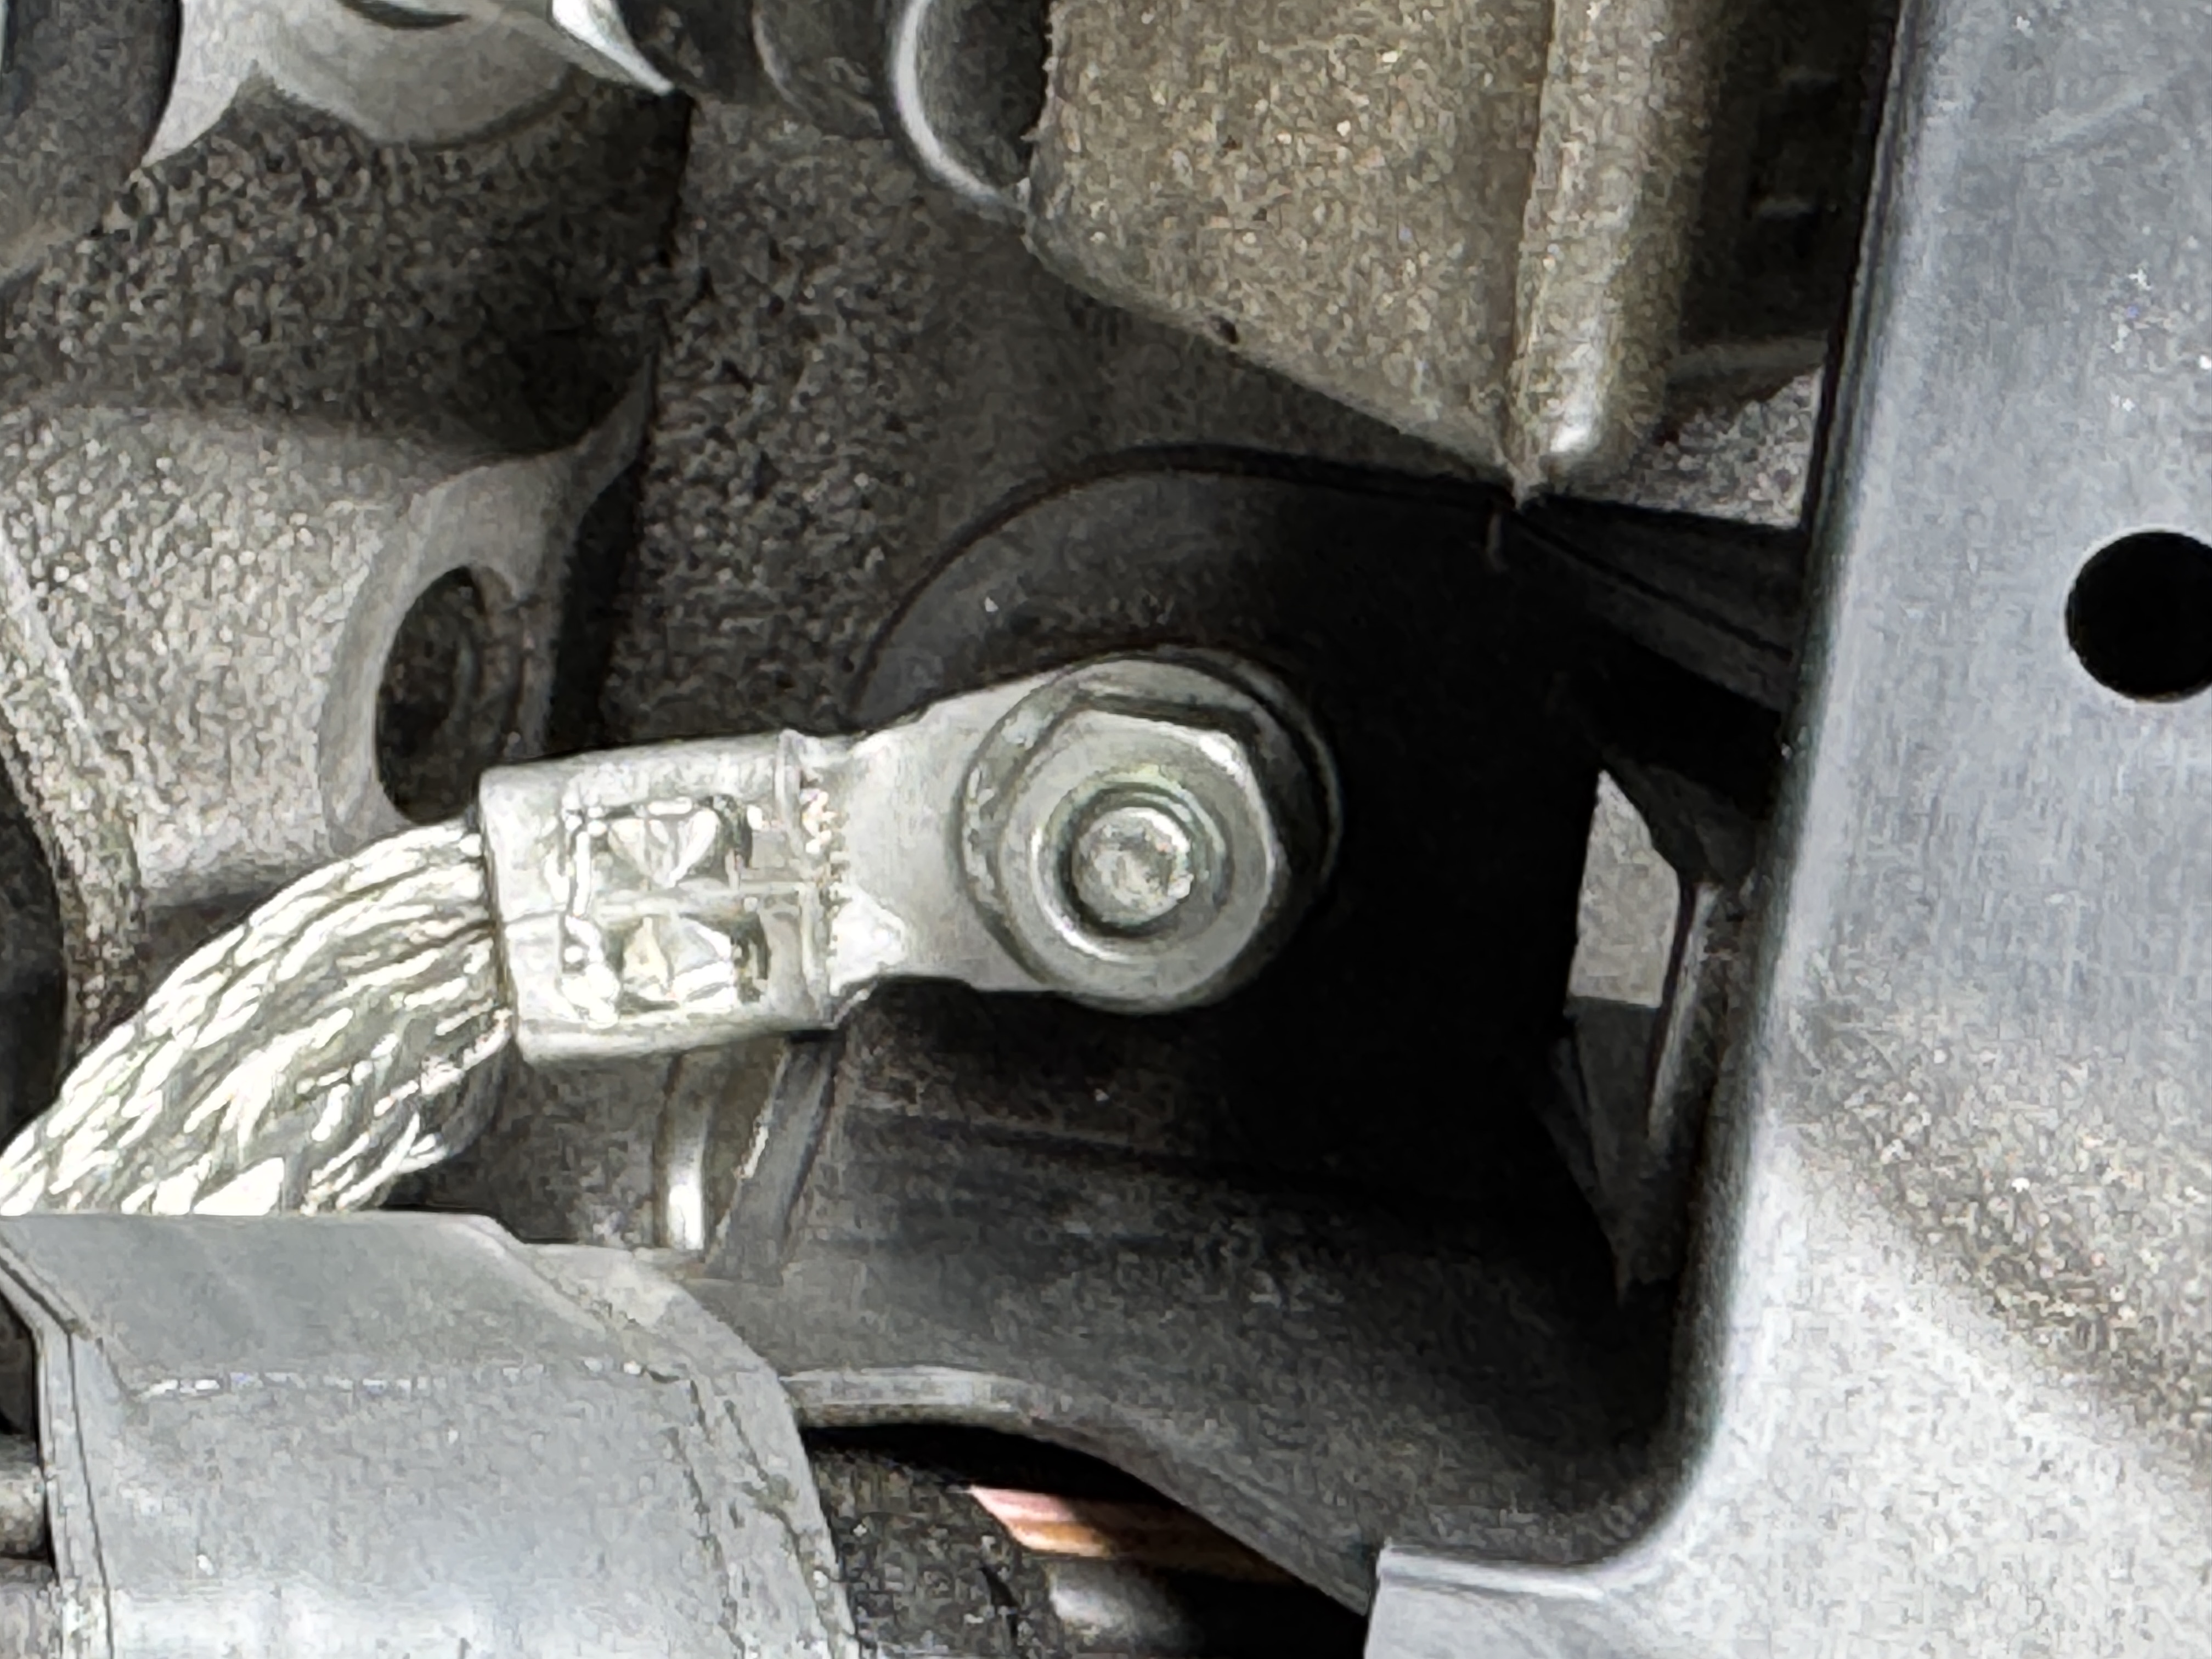
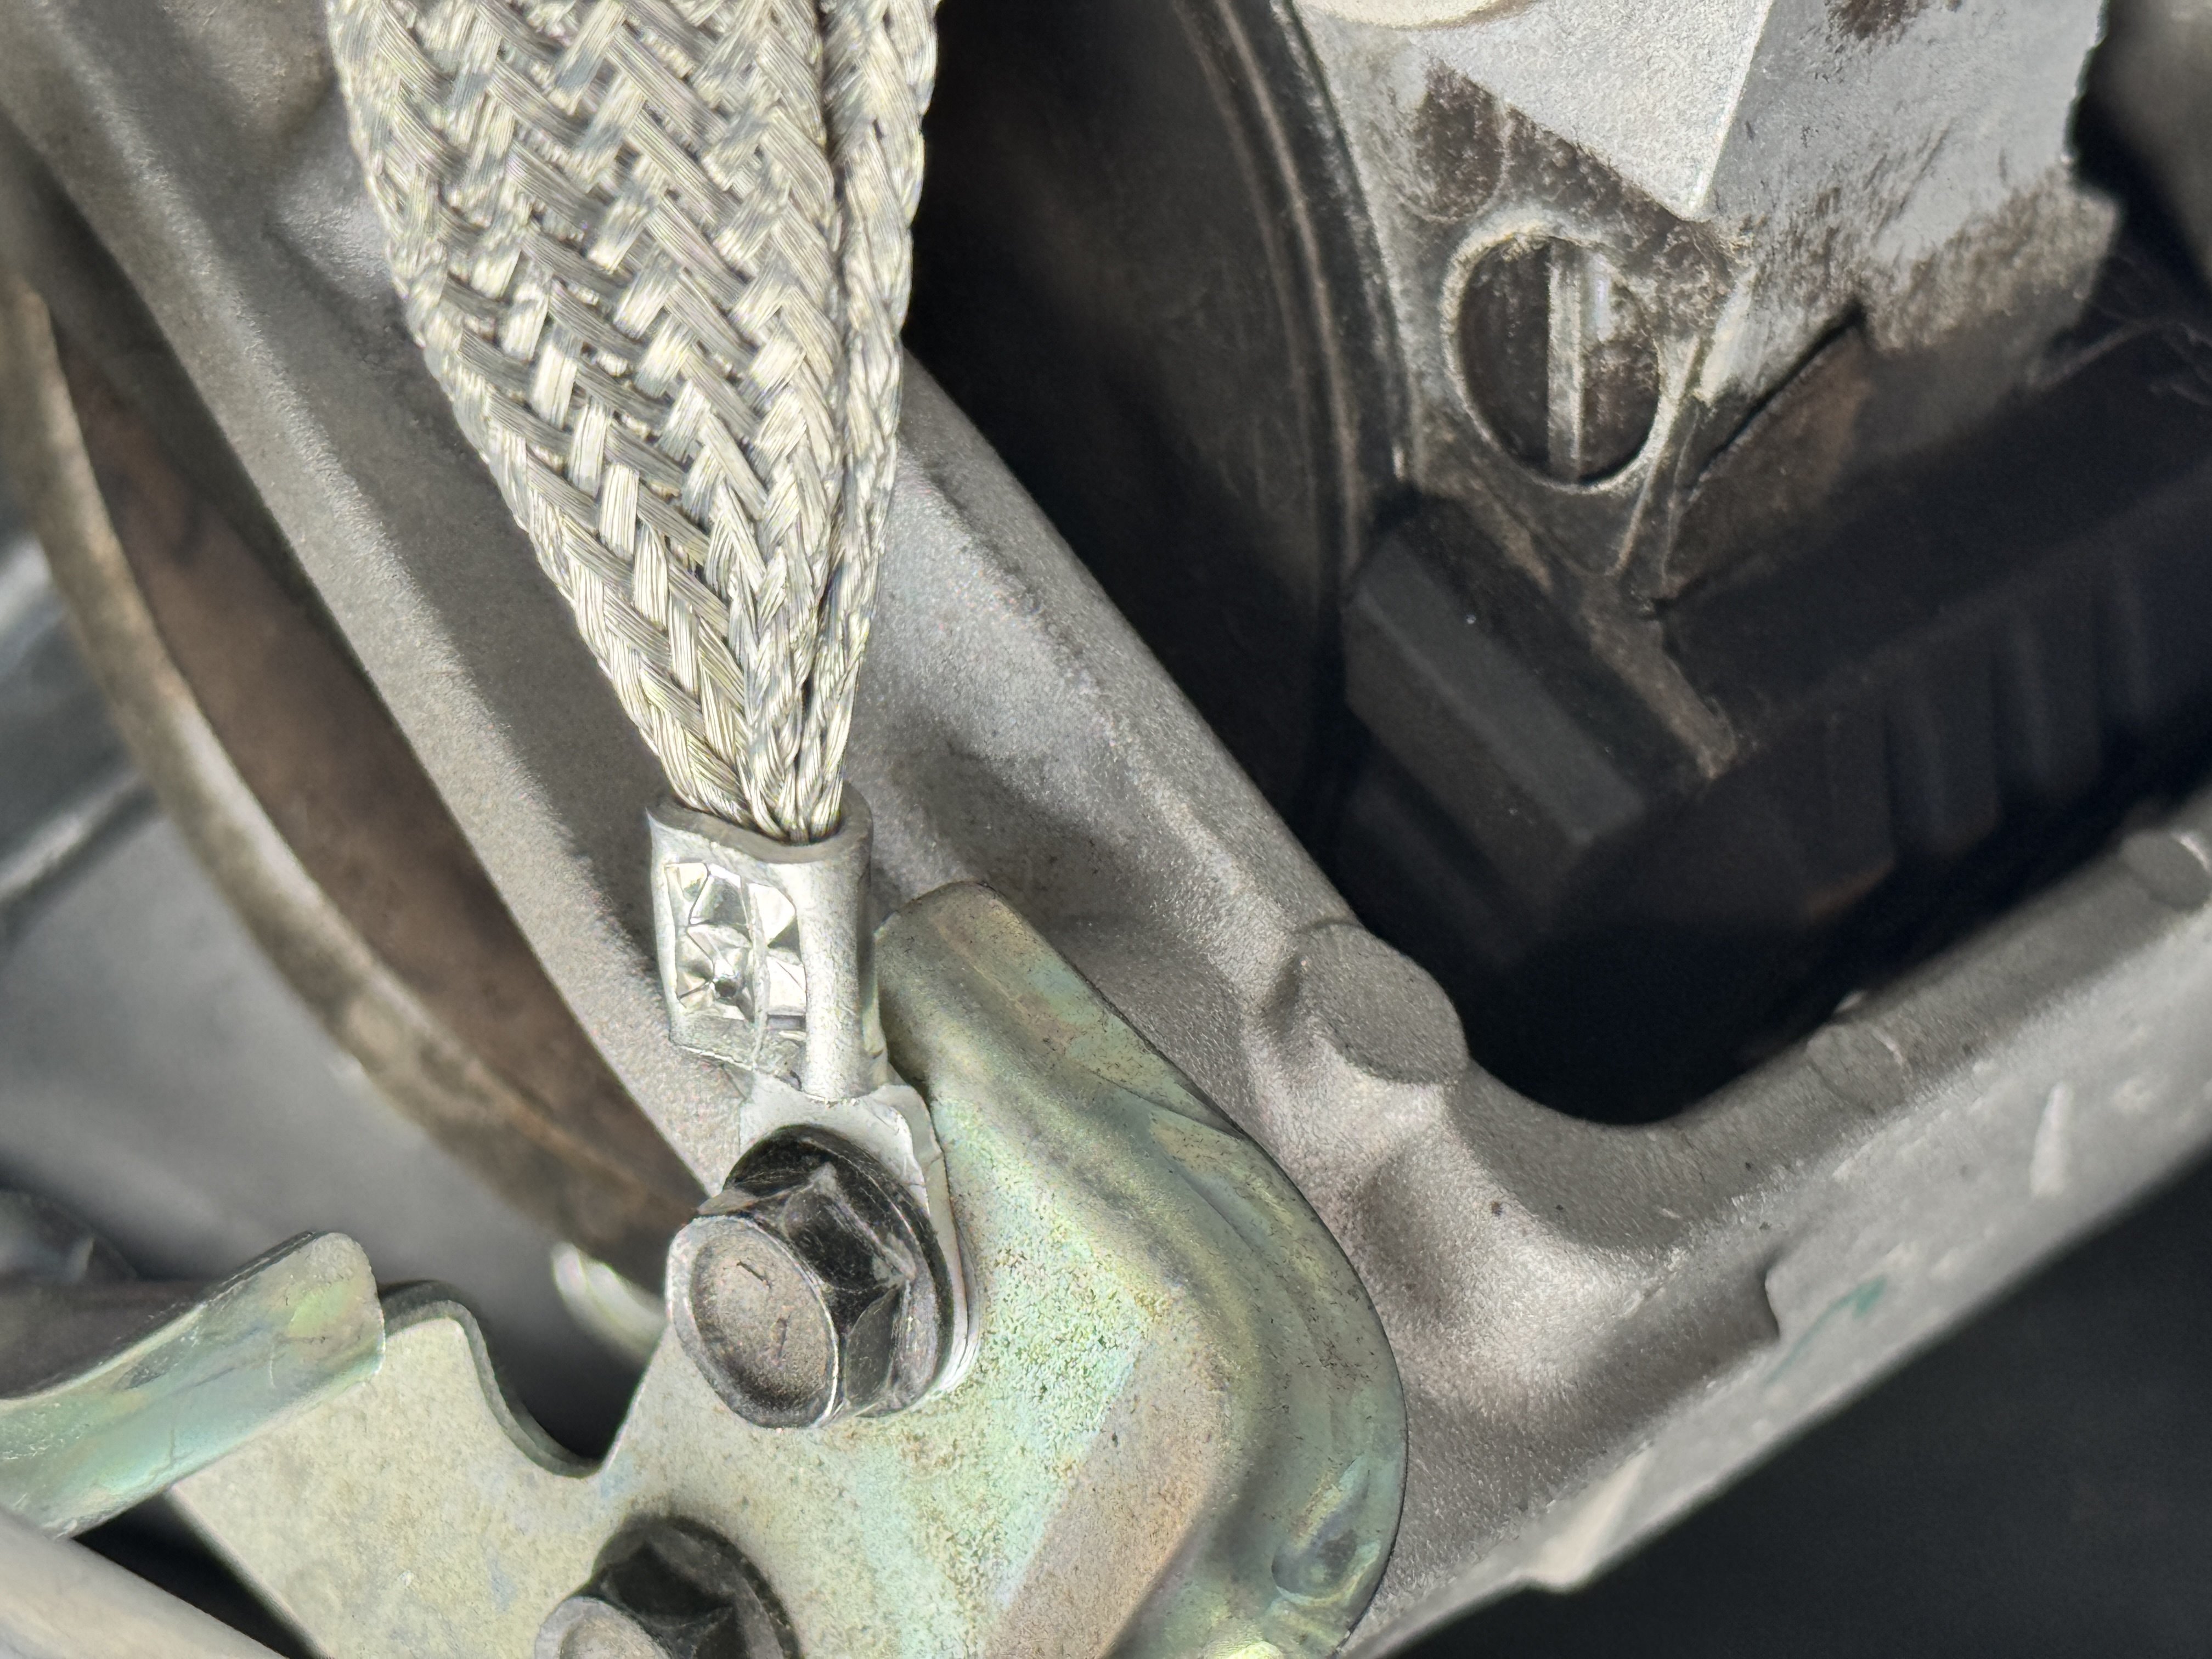
エンジンカバー装着前の全体像です。注意して見ると認識できる感じです。
エンジンカバーを装着すると更に判りづらくなります。
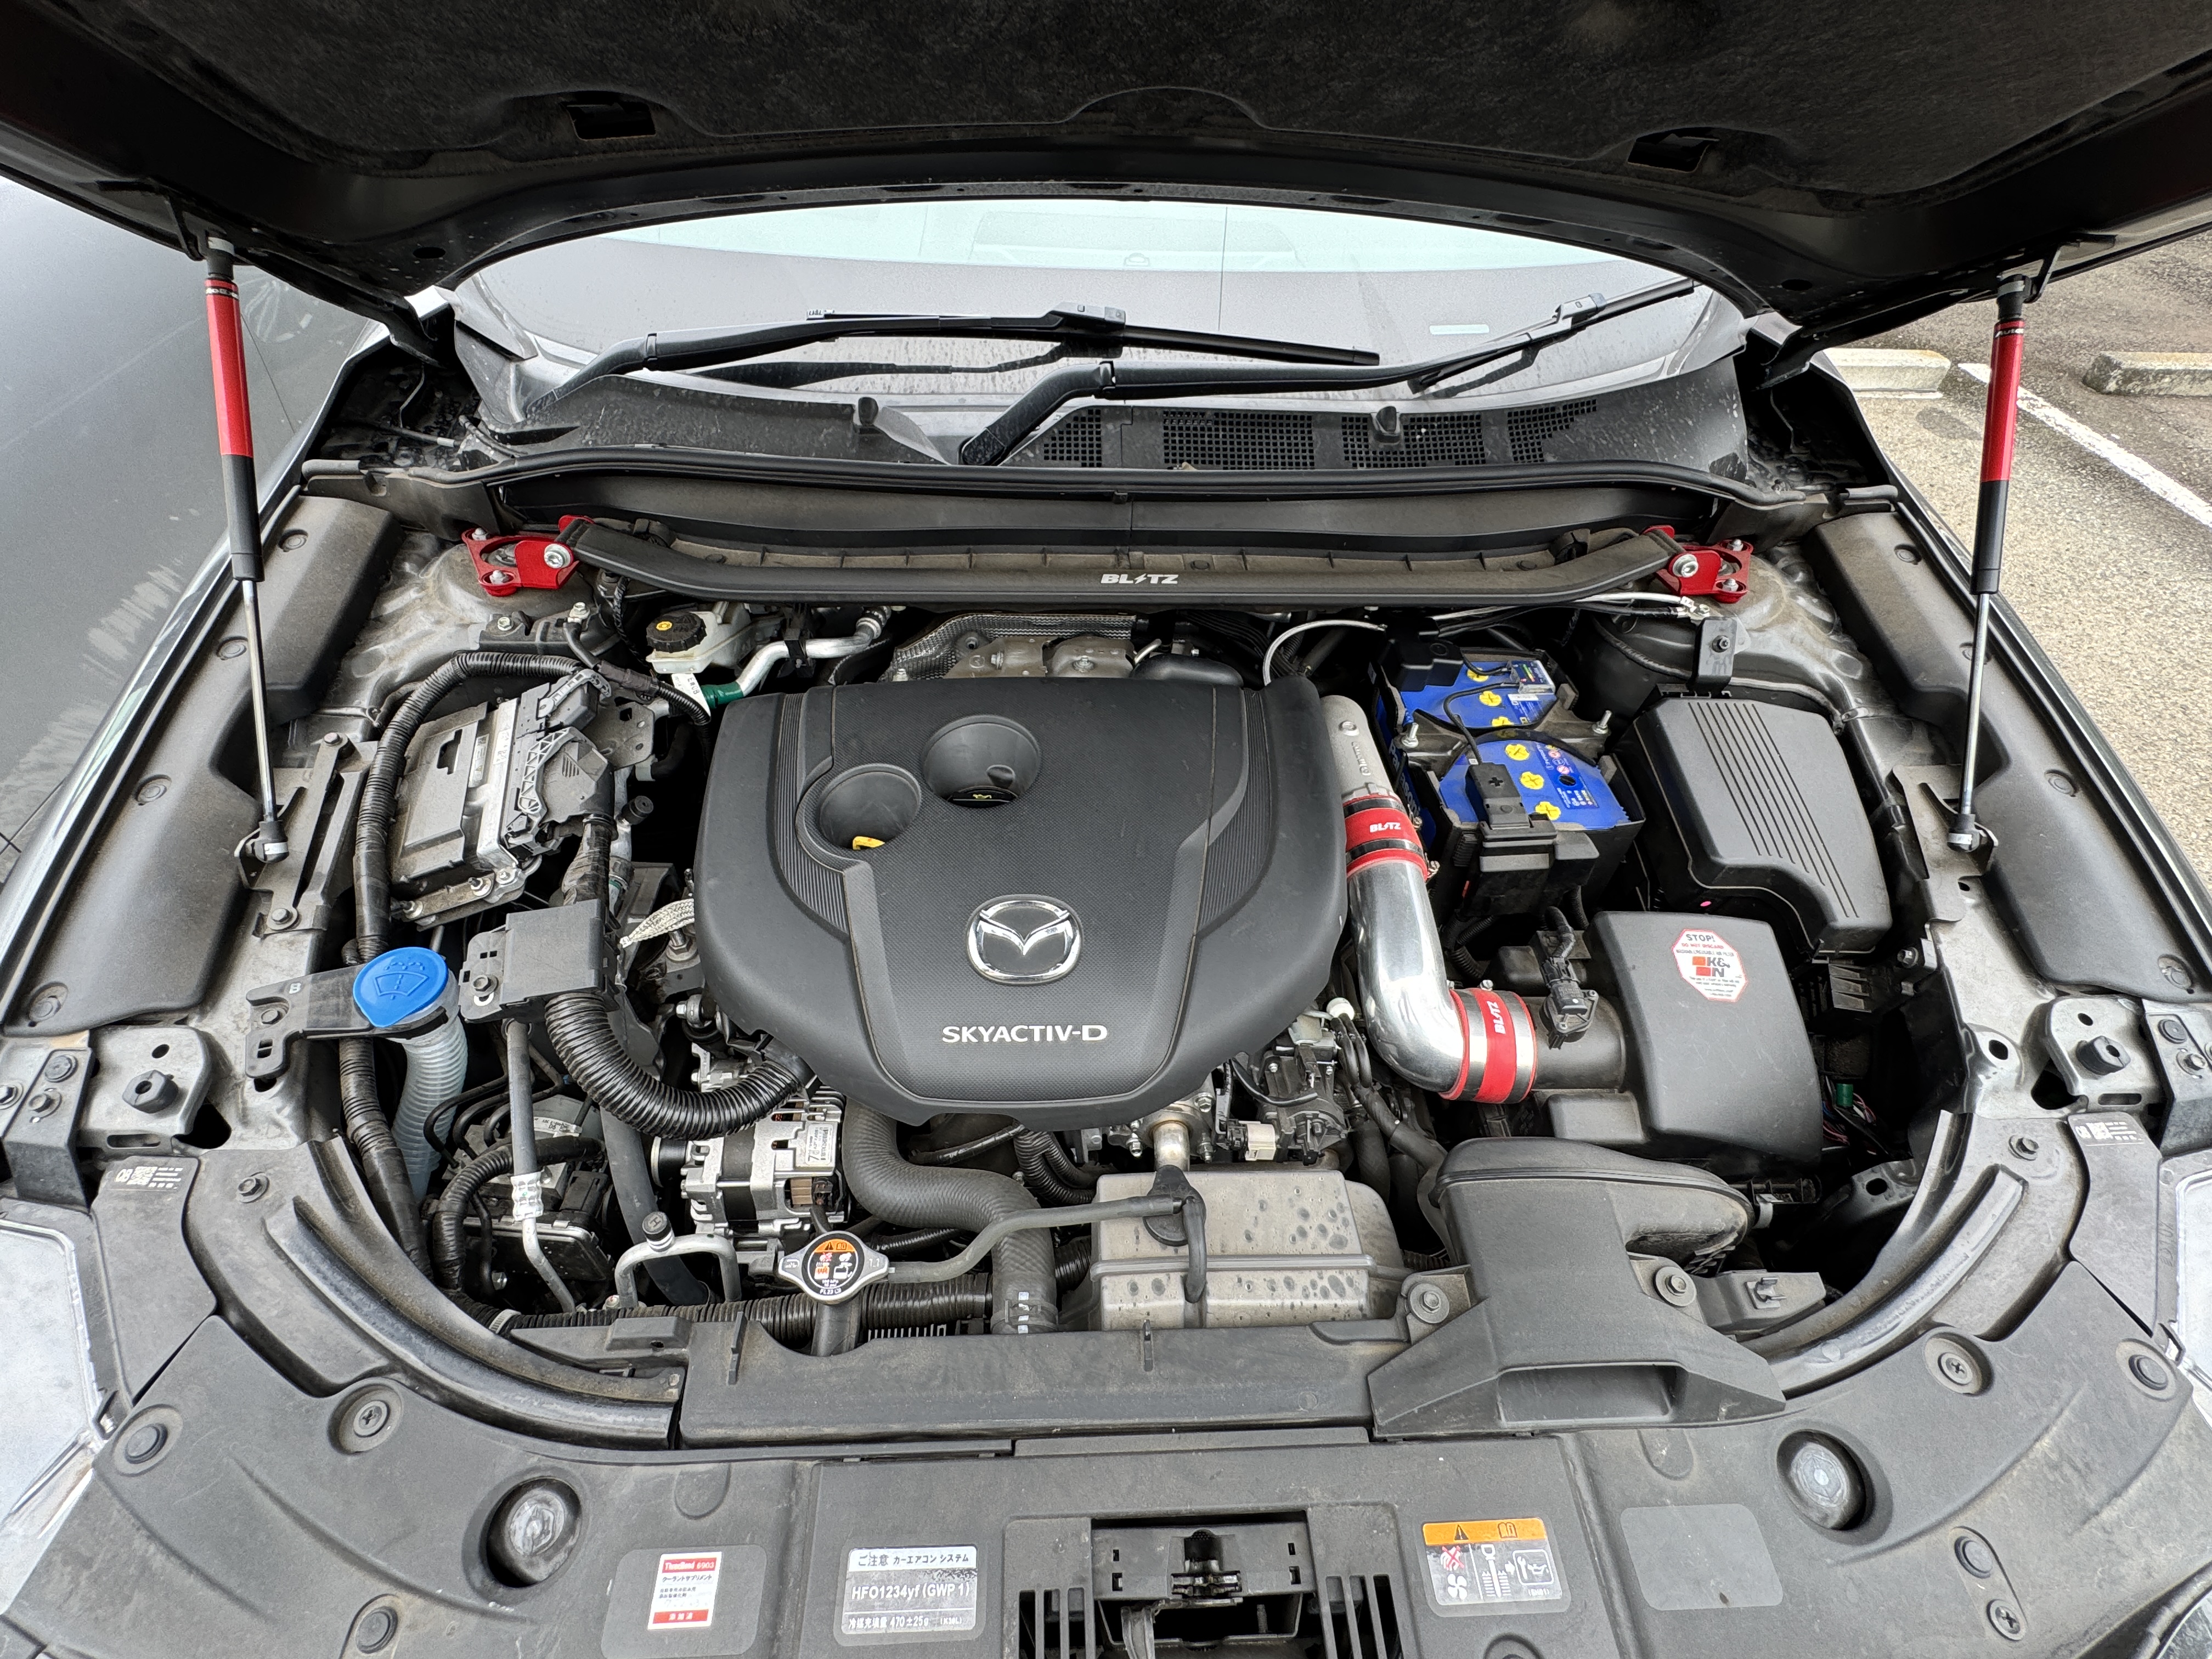
装着して試乗してみましたが何となくスロットルレスポンスが良くなった様な...(プラシーボ?)
一番期待しているのは煤対策なので暫く様子見ではあります。
2026/08/27
Linux ネットワークプログラミング
Linux 上で動作するネットワーク関係の C プログラムのスニペットです。
一部のコードは Linux 固有の機能を使っていますので残念ながら Linux 上でしか動作しません。
一応の動作確認は実施していますが、処理の概要を示しただけなのでエラー処理等は省いています。
実際に製品に組み込む場合はエラーチェック処理は必須です。
指定されたインタフェイスの情報を取得する
オープンされた L3 層の UDP ソケット (ネットワーク層) に対して ioctl(2) を発行する事で各種情報をカーネルから取得する事ができます。 ここでは例として以下の情報を取得して表示するコードを示します。
- アドレス
- ネットマスク
- MAC アドレス
  1/* ioctl(2) 用に socket を作成 */
  2if((sock = socket(AF_INET, SOCK_DGRAM, 0)) >= 0){
  3    const   char    *ifname = "eth0";
  4    struct  ifreq   ifr;
  5
  6    /* ioctl(2) 用にインタフェイス名をセット */
  7    memset(&ifr, 0, sizeof(ifr));
  8    strncpy(ifr.ifr_name, ifname, IFNAMSIZ - 1);
  9
 10    /* ioctl(2) を発行して IP アドレスを取得 */
 11    if(ioctl(sock, SIOCGIFADDR, &ifr) >= 0){
 12        struct sockaddr_in *src_ip_addr = (struct sockaddr_in *)&ifr.ifr_addr;
 13        printf("IP Address: %s\n", inet_ntoa(src_ip_addr->sin_addr));
 14    }
 15
 16    /* ioctl(2) を発行してネットマスクを取得 */
 17    if(ioctl(sock, SIOCGIFNETMASK, &ifr) >= 0){
 18        struct sockaddr_in *netmask_addr = (struct sockaddr_in *)&ifr.ifr_netmask;
 19        printf("Netmask: %s\n", inet_ntoa(netmask_addr->sin_addr));
 20    }
 21    /* ioctl(2) を発行して MAC アドレスを取得 */
 22    if(ioctl(sock, SIOCGIFHWADDR, &ifr) >= 0){
 23        unsigned    char *mac = (unsigned char *)ifr.ifr_hwaddr.sa_data;
 24        printf("MAC Address: %02x:%02x:%02x:%02x:%02x:%02x\n",
 25                mac[0], mac[1], mac[2], mac[3], mac[4], mac[5]);
 26    }
 27}
指定されたインタフェイスの対向アドレスを取得する
指定されたインタフェイスが Peer to Peer の場合はローカルと対向の IPv4 アドレスを取得します。 指定されたインタフェイスが Peer to Peer 以外の場合はどちらも同じ値となります。 L3 層の DGRAM ソケット (UDP ソケット) を使用しているので通常のユーザにも実行可能です。
  1if((sock = socket(AF_INET, SOCK_DGRAM, 0)) >= 0){
  2    const   char    *ifname = "eth0";
  3    struct  ifreq   ifr;
  4
  5    /* ioctl(2) 用にインタフェイス名をセット */
  6    memset(&ifr, 0, sizeof(ifr));
  7    strncpy(ifr.ifr_name, ifname, IFNAMSIZ - 1);
  8
  9    /* ioctl(2) を発行して自分自身のアドレスを取得 */
 10    if(ioctl(sock, SIOCGIFADDR, &ifr) >= 0){
 11        struct sockaddr_in *sin = (struct sockaddr_in *)&ifr.ifr_dstaddr;
 12    }
 13
 14    /* ioctl(2) を発行して対向のアドレスを取得 */
 15    if(ioctl(sock, SIOCGIFDSTADDR, &ifr) >= 0){
 16        struct sockaddr_in *sin2 = (struct sockaddr_in *)&ifr.ifr_dstaddr;
 17    }
 18}
指定されたインタフェイスと通信可能なアドレスの一覧取得
こちらは Linux 特有の NetLink という仕組みを利用して 指定されたインタフェイスの ARP テーブルを参照して通信可能な IPv4 アドレスを取得します。 サンプルではチェック処理などを省いていますが、 実際には環境によって大量のアドレスが取得できるので受け取り側のオーバーフローには要注意です。
  1const       char    *ifname = "eth0";
  2unsigned    int     index = if_nametoindex(ifname);
  3
  4if(index > 0){
  5    /* Netlink ソケットを開く */
  6    if((sock = socket(AF_NETLINK, SOCK_RAW, NETLINK_ROUTE)) >= 0){
  7
  8        /* リクエストメッセージの組み立て (RTM_GETNEIGH = ARPテーブル取得) */
  9        memset(&req, 0, sizeof(req));
 10        req.nlh.nlmsg_len = NLMSG_LENGTH(sizeof(struct ndmsg));
 11        req.nlh.nlmsg_flags = NLM_F_REQUEST | NLM_F_DUMP;
 12        req.nlh.nlmsg_type = RTM_GETNEIGH;
 13        req.ndm.ndm_family = AF_INET; /* IPv4を指定 */
 14
 15        /* カーネルに問い合わせ */
 16        if(send(sock, &req, req.nlh.nlmsg_len, 0) >= 0){
 17                /* カーネルからの応答を受信・パース */
 18                while((status = recv(sock, buff, sizeof(buff), 0)) > 0){
 19                        struct  nlmsghdr    *nlh;
 20
 21                        for(nlh=(struct nlmsghdr *)buff; NLMSG_OK(nlh, status); nlh=NLMSG_NEXT(nlh, status)){
 22                            /* メッセージ終了(DONE)ならループを抜ける */
 23                            if((nlh->nlmsg_type == NLMSG_DONE) || (nlh->nlmsg_type == NLMSG_ERROR)
 24                                break;
 25
 26                            struct ndmsg *ndm = (struct ndmsg *)NLMSG_DATA(nlh);
 27                            /* 対象のインターフェースインデックスと一致しない場合や
 28                             * 完全に死んでいるもの (NUD_FAILED や NUD_INCOMPLETE) は除外する
 29                             */
 30                            if((ndm->ndm_ifindex != index) || (ndm->ndm_state & (NUD_INCOMPLETE | NUD_FAILED)))
 31                                continue;
 32
 33                            /* 属性(IPアドレスやMACアドレス)をパース */
 34                            struct  rtattr  *rta = (struct rtattr *)((char *)ndm + NLMSG_ALIGN(sizeof(struct ndmsg)));
 35                            int     rta_len;
 36
 37                                for(rta_len = nlh->nlmsg_len - NLMSG_LENGTH(sizeof(struct ndmsg));
 38                                            RTA_OK(rta, rta_len);
 39                                            rta = RTA_NEXT(rta, rta_len))
 40                                    /* NDA_DST が宛先IPアドレス(ARPテーブルのIP)を示す */
 41                                    if(rta->rta_type == NDA_DST)
 42                                        ipaddr[i++] = *(unsigned long *)RTA_DATA(rta);
 43                        }
 44                }
 45        }
 46        close(sock);
 47    }
IPアドレスとネットマスクを元にユニキャストアドレスを抽出
IPv4アドレスの一覧からブロードキャストアドレスやネットマスクなどの情報を除外して ユニキャストアドレスだけを抽出する処理です。
  1unsigned    long    target_ip,
  2                    my_ip,
  3                    netmask;
  4
  5/* 255.255.255.255 もしくは 0.0.0.0 は除外 */
  6if(target_ip == 0xffffffff || target_ip == 0)
  7    return 0;
  8
  9/* マルチキャストアドレス (224.0.0.0 - 239.255.255.255) を除外 */
 10/* target_ip の第 1 オクテットをチェック */
 11unsigned    char    *ip_bytes = (unsigned char *)&target_ip;
 12
 13if(ip_bytes[0] >= 224 && ip_bytes[0] <= 239)
 14    return 0;
 15
 16unsigned    long    network_addr = my_ip & netmask,
 17                    broadcast_addr = my_ip | ~netmask;
 18
 19/* ネットマスクもしくはブロードキャストアドレスを除外 */
 20if(target_ip == network_addr || target_ip == broadcast_addr)
 21    return 0;
 22else if(ip_bytes[3] == 255 || ip_bytes[3] == 0)
 23    return 0;
IPv4アドレスがネットワークに属しているか確認する
  1const   char    *net,
  2                *mask,
  3                *addr;
  4
  5if(inet_pton(AF_INET, network, &net) == 1 &&
  6    inet_pton(AF_INET, netmask, &mask) == 1 &&
  7    inet_pton(AF_INET, ipaddr, &addr) == 1){
  8
  9    // ネットワークアドレス側はすでにマスク済みの想定であれば、左辺のマスクは省略可能です
 10    return(addr.s_addr & mask.s_addr) == net.s_addr;
 11}
CIDR 形式にも対応させる
  1const   char    *net,
  2                *mask
  3                *addr;
  4
  5if(prefix >= 0 && prefix <= 32){
  6    if(inet_pton(AF_INET, network, &net) == 1 &&
  7            inet_pton(AF_INET, ipaddr, &addr) == 1){
  8        /* プレフィックス長からホストバイトオーダーでマスクを作成して
  9         * ネットワークバイトオーダー(ビッグエンディアン)に変換
 10         */
 11        uint32_t mask = htonl((prefix == 0) ? 0 : (~0U << (32 - prefix)));
 12
 13        return(addr.s_addr & mask) == (net.s_addr & mask);
 14    }
 15}
複数回実行される場合の高速化
ループ内など複数回実行される場合は文字や変換処理など inet_pton(3) がボトルネックになってしまうので、 あらかじめネットワークアドレスとネットマスクを数値データ (uinit_32) に変換して保持しておいた方が高速化できます。
  1/* ネットワーク情報を保持しておく構造体 */
  2typedef struct{
  3    uint32_t    net;
  4    uint32_t    mask;
  5} rule;
  6
  7/* あらかじめ IPv4 アドレスも unit32 に変換する */
  8uinit_32    addr;
  9
 10/* 判定処理は数値演算のみ */
 11return(addr & rule->mask) == rule->net;
2026/08/21
C 言語の変数定義
C 言語の変数定義は宣言部に若干クセがあるのでまとめました。
ローカル変数
変数のスコープが宣言されたブロックの内側に限定される変数です。
ブロックとは { と } の内側などで、一番判りやすいのは関数の宣言部分です。
以前は変数宣言はブロックの先頭のみで可能でしたが
ISO/IEC 9899:1999 (C99) から任意の場所の変数宣言が可能となっています。
  1int     foo(void)
  2{
  3
  4    int     i;
  5
  6    i = 0;                  /* ローカル変数 */
  7
  8    {
  9        int     j;          /* ローカル変数 */
 10            :
 11    }
 12
 13    /* ここでは j は参照できない */
 14
 15}
ローカル変数の特徴を以下に示します。
- スコープ (有効範囲)は宣言されたブロック内に限られます。
- 関数の呼び出しごとに新しく確保され関数から戻るときに破棄されます。
- 実体は基本的に後述するスタック上に置かれます。
- 初期化しないと値は不定で内容は保証されていません。
グローバル変数
関数の外で宣言する変数です。
  1int     status;                 /* グローバル変数 (初期値は 0) */
  2
  3int     foo(void)
  4{
  5
  6    if(status == 1){            /* ファイル内のどこからでも参照できる */
  7        :
グローバル変数の特徴を以下に示します。
- スコープはファイル全体です (extern を宣言する事で他ファイルからもアクセス可能)。
- プログラム開始時に確保され終了するまで存在し続けます。
- 明示的に初期化しなくても自動的に 0 で初期化されます。
- 実体は実行ファイル内の「データ領域」に配置されます。
メモリレイアウトとスタック
典型的なプロセスのメモリ空間はアドレスの低い方から高い方へおおよそ次のように並びます。
スタックの動作(スタックフレーム)
関数を呼び出すたびに、スタック上に「スタックフレーム」と呼ばれる領域が積まれます。中身はおおよそ次のようなものです。
- 呼び出し元に戻るためのリターンアドレス
- 呼び出し元のベースポインタの退避値(スタックフレーム同士を辿るため)
- 引数(レジスタ渡しの場合もあります)
- その関数のローカル変数
具体的なスタック利用の流れ
  1int     add(int a, int b)
  2{
  3
  4    int result = a + b;     /* ローカル変数はこの関数のスタックフレームに置かれる */
  5
  6    return result;
  7
  8}
  9
 10int     main(void)
 11{
 12
 13    int x = 3,
 14          y = 4;
 15    int z = add(x, y);      /* add() 呼び出し時に新しいスタックフレームが積まれる */
 16
 17    printf("%d\n", z);
 18
 19    return 0;
 20
 21}
- main() が呼ばれるとスタックに main() 用のフレームが積まれ(プッシュ)、 スタック上に変数 x、y、z が確保されます。
- 関数 add(x, y) が呼ばれるとスタックにリターンアドレスなどを積んだ上で さらに add() 用のフレームが積まれ、引数 a、b、変数 result が確保されます。
- add() が return するとそのフレームはスタックから取り除かれ(ポップ)、 制御は main() に戻ります。 add() のローカル変数 (a、b、result) はこの時点で消滅します。
- main() が return すると、main() のフレームも取り除かれます。
ダングリングポインタによる BUG
関数 add() を少し変更して文字列を操作する関数に変えてみます (例示のためなのでチェック処理やエラー処理などは実施していません)。
  1char    *add(char *a, char *b)
  2{
  3
  4    char    result[1024];               /* ローカル変数はこの関数のスタックフレームに置かれる */
  5
  6    snprintf(result, sizeof(result), "%s%s", a, b);
  7
  8    return result;
  9
 10}
 11
 12int     main(void)
 13{
 14
 15    char    *x = "foo",
 16            *y = "bar";
 17    char    *z = add(x, y);         /* 関数 add() のローカル変数を参照 */
 18
 19    printf("%s\n", z);
 20
 21    return 0;
 22
 23}
関数 add() はローカル変数 result のアドレスをリターンしていますが、 前述の通り result はスタック上に確保された変数のため add() のリターン後は値は保証されません。 リターンした値はスタックのアドレスを示していますが値は保証されていません。 そのため z の値は不定となってしまいます。 関数からローカル変数をリターンする場合は必ず値をリターンする必要があります。 C 言語の仕様として配列の名前を参照した場合は配列の先頭要素を指すアドレスとして扱われますので特に注意が必要です。 この様にローカル変数のアドレスをリターンする事をダングリングポインタと呼びます。
再帰とスタックオーバーフロー
このLIFO (Last In First Out) 構造のおかげで、 関数呼び出しが何段ネストしても各関数は自分専用の変数領域を持てますし、 再帰呼び出しでも呼び出し回数分のフレームが積み重なるだけで正しく動作します。 逆に言うと、再帰が深すぎたり、ローカルに巨大な配列を確保しすぎたりすると、 このスタック領域を使い切って「スタックオーバーフロー」を起こします。
  1void    recurse(int n)
  2{
  3
  4    char    buf[1024 * 1024];           /* 1関数呼び出しごとに 1MB 消費 */
  5
  6    recurse(n + 1);                     /* 再帰呼び出し (すぐにスタックが尽きる) */
  7
  8}
とは言っても再帰呼び出しする場合は staic 変数は BUG の原因となるので、 再帰呼び出しの可能性がある場合は static 変数は使わない方が良いです。
以下は static 変数を利用したために不正な値となってしまう階乗計算処理です。
  1int     count(int n)
  2{
  3
  4    static  int total = 0;              /* すべての再帰で共有される */
  5
  6    total *= n;
  7    if(n > 0)
  8        count(n - 1);                   /* 再帰呼び出し */
  9
 10    return total;
 11
 12}
 13
 14int     main(int argc, char *argv[])
 15{
 16
 17    printf("%d\n", count(atoi(argv[1])));
 18
 19    return 0;
 20
 21}
この様な BUG の温床になってしまう事もあるので、 特に最近では再帰呼び出し自体を悪だとする風潮もある様ですが 再帰呼び出し便利なんですよね...ついつい使ってしまいます。
static 宣言
C 言語の static 修飾子は文脈によって複数の意味と効果を持っているので初心者の頃は混乱しがちです。 そもそも複数の効果を持つ修飾子を同じ名前にするな...と Dennis に言いたい。
関数内の static 変数
関数の内部での static 修飾子は記憶クラスを定義します。 static 指定の変数を定義すると変数は前述のデータ領域に置かれ関数が終了した後も値が保持されますが、 変数のスコープはローカル変数同様にブロックの内部のみとなっています。 以下の関数 foo() では最初に呼ばれた時のみ変数 i が 0 で初期化され、 呼び出し毎に i がインクリメントされます。 2 回目の呼び出しでは i は 2 に、10 回目の呼び出しでは i は 10 となります。 当然ですが関数 foo() の外側では i は参照できません。
  1int     foo(void)
  2{
  3
  4    static  int     i = 0;          /* 変数領域は .data に確保され初期値として 0 が設定される */
  5
  6    i++;
  7
  8}
ファイルのグローバル変数
グローバル変数への static 修飾子は変数のスコープを定義します。 static 指定の変数はスコープがファイル内に制限されます。 static 修飾子を指定しない変数は他のファイルで extern を指定する事で参照する事ができますが、 static 修飾子を指定された変数は extern 指定されても他のファイルからは参照できません。
  1/* ファイル foo.c */
  2static  int     result;         /* 他のファイルから参照不可 */
  3        int     status;         /* 他のファイルから参照可能 */
  4
  5    :
  6
  7/* ファイル bar.c */
  8extern  int     status;         /* foo.c の status を参照 */
  9extern  int     result;         /* foo.c の result は参照できない (通常はコンパイル時にリンクエラーとなる) */
 10
 11    :
関数の指定
関数の宣言に static 修飾子を指定した場合はファイルのグローバル変数同様関数のスコープを定義します。 static 修飾子を指定した関数はスコープがファイル内に制限されます。 static 修飾子を指定しない関数は extern 指定する事で他のファイルからも呼び出す事ができますが、 static 修飾子を指定された関数は extern 指定されても他のファイルからは呼び出せません。
まとめ
グローバル変数は値を保持しグローバルに参照できるので便利な変数です。 しかし、多用すると処理全体の見通しが悪くなったり関数の独立性が阻害されてしまうので、 どうしても必要な場合に限ったほうが良いでしょう。
|
|
ローカル変数 | グローバル変数 | |
|---|---|---|---|
| 宣言位置 | 関数 / ブロック内 | 関数外 | |
| スコープ | そのブロック内のみ | ファイル全体 (extern で他ファイルも可) | |
| 記憶域期間 | 自動 (関数終了で消滅) | 静的 (プログラム終了まで存在) | |
| 確保場所 | スタック (static 以外) | データ / BSS 領域 | |
| 初期値 | 不定 | 自動的に 0 | |
| 主なリスク | スタックオーバーフロー、ダングリングポインタ | 名前衝突、意図しない状態共有によるバグ、マルチスレッドでの競合 |
2026/08/20
Cシステムコールとライブラリ関数
C 言語からコールする関数には大きく分けて システムコール と ライブラリ関数 の2種類があります。
どちらも関数呼び出しの見た目をしているため区別がつきにくいのですが、実行時の仕組み、コスト、権限モデルはまったく異なります。
そこで、両者の定義と違いを整理したうえで、システムコール実行時に発生するコンテキストスイッチが
OS やアプリの性能にどのような負荷・影響を与えるかを簡単に解説します。
システムコール
システムコールとは、ユーザー空間で動作するプログラムがカーネルの機能を利用するための唯一の手段です。man 2 open のようにマニュアルのセクション 2 に分類されています。
システムコールには open(2)、read(2)、write(2)、socket(2) などがあります。
CPU には一般に実行できる命令や参照できるメモリ領域に制限のある「ユーザーモード」と、 すべての命令、メモリ空間、I/O ポートにアクセスできる「カーネルモード (特権モード)」の2つの動作モードがあります。 Unix や Linux を始めとするモダンな OS では、アプリケーションプログラムは基本的にユーザーモードで動作していて、 ディスクへの直接アクセスやプロセス管理などの危険な操作はハードウェア的に禁止されています。 そこで、こうした操作が必要な場合は CPU に用意された特別な命令を実行して、 CPU のモードをユーザーモードからカーネルモードへ切り替える必要があります。 Unix や Linux においてこの切り替えを実行するのがシステムコールです。
ライブラリ関数
ライブラリ関数は C 標準ライブラリ (libc) やその他のライブラリが提供するユーザー空間だけで完結する通常の関数です。man 3 printf のようにマニュアルのセクション3に分類されています。
ライブラリ関数の分類
ライブラリ関数は大きく 2 種類に分類できます。- システムコールを呼び出さない純粋なライブラリ関数
- 内部でシステムコールをラップしているライブラリ
strlen(3)、 sin(3) などで、これらは文字列操作や CPU 上での計算処理のみで完結しカーネルには影響しません。
fopen(3)、fread(3)、printf(3) などで、 これらは最終的に内部で open(2)、read(2)、write(2) といった システムコール発行していますが、 その前後でバッファリング、書式変換、エラー処理の付加などユーザー空間側の便利な処理を行っています。
たとえば fwrite(3) は、呼び出しのたびにシステムコール write(2) を発行するわけではなく、
FILE 構造体が持つユーザー空間のバッファにデータを蓄積して、バッファが一杯になった時、
あるいは fflush(3) や fclose(3) が呼ばれた時にまとめて
write(2) システムコールを発行する事で、システムコール呼び出し回数を減らし性能を大きく向上させています。
ライブラリ関数には fopen(3)、fread(3)、fwrite(3) などがあります。
コンテキストスイッチ
コンテキストスイッチとは、CPUがあるコンテキストから別のコンテキストへ切り替える処理全般を指します。
コンテキストスイッチの種類
コンテキストスイッチには大きく分けて 2 種類あります。- モード切り替
- プロセス切り替え
前述したカーネルモードとユーザーモードの切り替えです。
このタイプのコンテキストスイッチはシステムコール発行や割り込み・例外発生時に起こります。
同一プロセス内での切り替えであり、後述する「プロセス切り替え」よりコストは小さいですがそれなりに負荷やコストがかかります。
OS のスケジューラがプロセス/スレッドの実行を中断して別のプロセス/スレッドに実行を渡す処理です。 タイムスライスの満了、I/O 待ちによるブロック、割り込みによるプリエンプションなどで発生します。 ページテーブル (= アドレス空間) 自体が切り替わるためモード切り替えよりもさらにコストが大きくなります。
システムコールは、必ずモード切り替えを伴います。 更にそのシステムコールの処理が入出力など I/O 待ちなどでブロックが発生する場合には さらにプロセス切り替えを誘発することもあります。
コンテキストスイッチのシステム負荷・影響
モード切り替え(システムコール発行)のコスト要因
システムコールを 1 回発行するだけでも以下のような処理コストが発生します。- レジスタの退避・復元
- 特権レベルの遷移
- パイプラインフラッシュ・投機実行のリセット
呼び出し元の CPU レジスタ一式をカーネルスタックへ保存し復帰時に復元します。
CPU 内部の カーネルモードへの遷移、および復帰時のユーザーモードへの遷移で、CPU の内部的な検証・準備処理を伴います。
モード遷移命令は CPU の命令パイプラインをある程度フラッシュさせ、 投機実行による先読みの効果を失わせます。
これらの要因により、単純なシステムコール 1 回の呼び出しコストは、通常の関数呼び出しと比較して 100 から 1000 倍以上のコストがかかります。
プロセス/スレッド切り替えのコスト要因
システムコールがブロッキング I/O などで待ち状態に入ると、 OS のスケジューラは別のプロセス/スレッドを実行するためにプロセス切り替えを行いますが、 これには前述のモード切り替えのコストに加えて以下のコストが上乗せされます。- ページテーブルの切り替え
- スケジューラの実行コスト
- キャッシュの入れ替え
アドレス空間が完全に入れ替わるためTLB 全体が無効化されます。
次に実行すべきプロセス / スレッドを選択するためのスケジューラの処理が実行されます。
キャッシュに載っていた前プロセスのデータ・命令が新しいプロセスのアクセスによって徐々に追い出される事により、 キャッシュミス率が一時的に急増して実行速度が低下します。
頻繁なシステムコールがもたらすシステム全体への影響
例えばアプリケーションが 1 バイトずつ read(2) や write(2) システムコールを呼び出すような設計をすると、 以下のような問題が顕在化します。- スループットの低下
- CPU 使用率の増加
- キャッシュ効率の悪化
- スケーラビリティの低下
- レイテンシのジッター増加
システムコール自体のオーバーヘッドがボトルネックとなり本来の I/O 帯域を活かせなくなります。
ユーザー時間ではなくシステム時間として CPU 時間が消費されてしまうので、システムの実行時間が高くなります。
頻繁なモード切り替えにより CPU キャッシュのヒット率が下がり、 システムコールを呼ばないコードパスの実行速度まで間接的に低下し、結果としてシステム全体のパフォーマンスが低下します。
マルチコア環境では頻繁なシステムコールがカーネル内部の共有データ構造の競合を引き起こすので、 コア数を増やしても性能が線形にスケールしない原因となり得ます。
割り込みやシステムコールによるコンテキストスイッチが頻発すると、リアルタイム性が求められる処理でジッターが増加します。
まとめ
システムコールはカーネルが提供するハードウェア資源にアクセスするための唯一の方法で、 呼び出しの都度、CPU のコンテキストスイッチが発生します。 一方ライブラリ関数は、多くの場合ユーザー空間だけで完結し、 内部でシステムコールをラップしている場合でもバッファリングなどによって呼び出し回数を抑える設計がされています。 プログラムの要件や仕様などでライブラリ関数では機能が不十分だったり、 特殊な制御が必要な場合以外はライブラリ関数を利用するのが好ましいです。
付録
具体例による比較を実施してみました。実行時間の計測はどちらも Intel CPU 上で稼働する Linux にて実施しました。
システムコールを利用する場合
1 バイト書き込むたびにシステムコール (=モード切り替え) が発生するため、コンテキストスイッチのコストが積み重なり著しく遅くなります。1#include <unistd.h> 2#include <fcntl.h> 3 4int main(void) 5{ 6 7 int fd, 8 i; 9 10 if((fd = open("out.txt", O_WRONLY | O_CREAT, 0644)) >= 0){ 11 for(i=0; i<100000; i++) 12 write(fd, "x", 1); 13 close(fd); 14 } 15 16 return 0; 17 18}
$ time ./syscall

real    0m0.124s
user    0m0.018s
sys     0m0.106s
ライブラリ関数を利用する場合
ユーザー空間でバッファリングしてからまとめて write(2) を呼ぶため システムコール発行回数が数百分の一以下に抑えられ高速に動作します。1#include <stdio.h> 2int main(void) 3{ 4 5 int i; 6 FILE *fp; 7 8 if((fp = fopen("out.txt", "w"))){ 9 for(i=0; i<100000; i++) 10 fputc('x', fp); 11 fclose(fp); 12 } 13 14 return 0; 15 16}
$ time ./library

real    0m0.003s
user    0m0.001s
sys     0m0.001s